

 2026-11-02 16:00:00


智猩猩AI整理
编辑:林夕
刚刚,美团龙猫发布原生多模态模型LongCat-2.5,总参数量达1.6万亿,每个token激活约480亿参数,在LongCat-2.0的基础上,进一步强化视觉理解与智能体编程能力。
新模型面向复杂代码库开发、完整项目构建等长程任务,可接入Claude Code、Codex、Hermes等Agent框架。
官方同步展示了实时流体模拟、3D文物展览、城市沙盘以及经营分析等应用案例。
价格方面,LongCat-2.5已公布API限时优惠价:每百万tokens缓存命中输入0.04元、缓存未命中输入2元、输出8元。
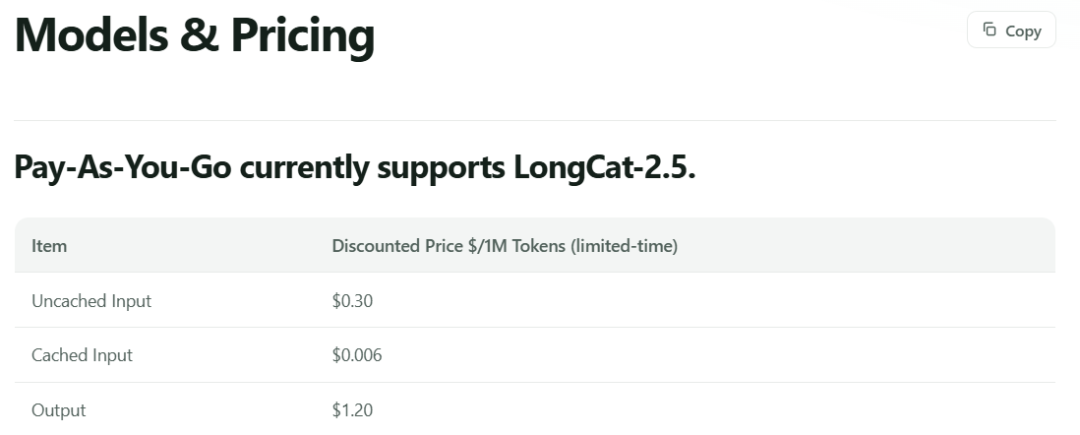
按目前两家官方公布的人民币价格,这三项单价均与DeepSeek Flash高峰价持平。
同时,官方公布的九项评测中,LongCat-2.5均超过Opus 4.8,并在AutomationBench、BrowseComp、3DCodeBench和LongCatClawBench四项测试中位居图示模型首位。
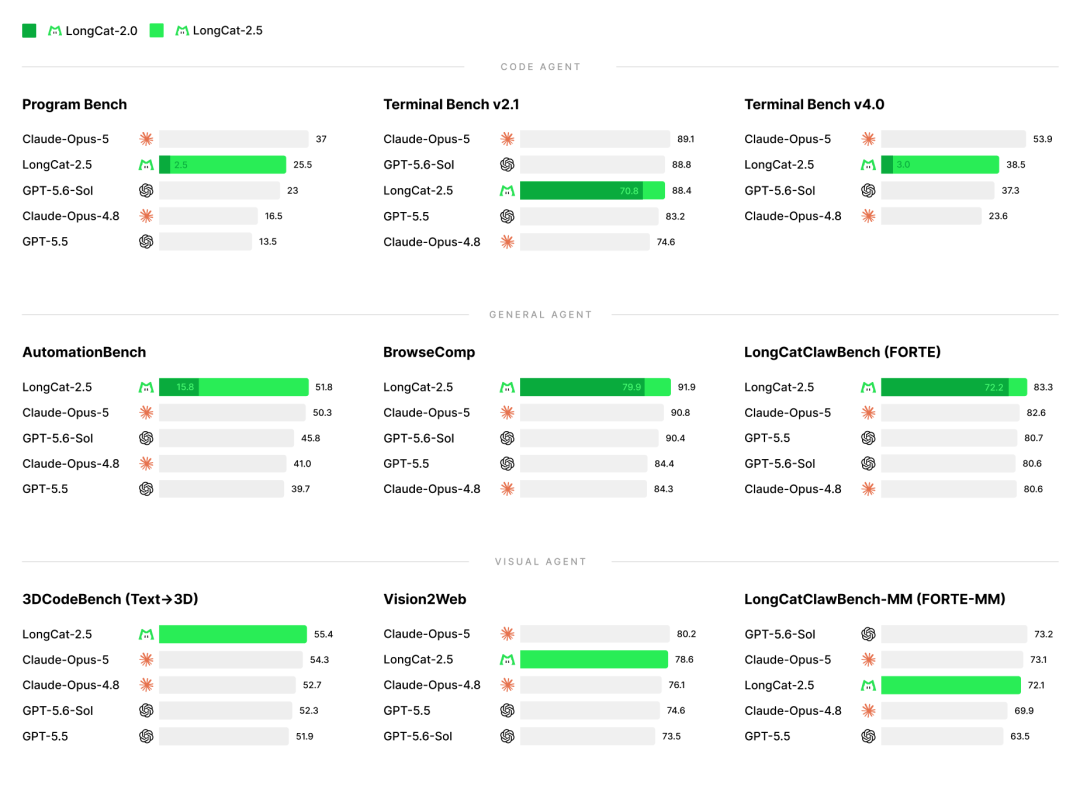
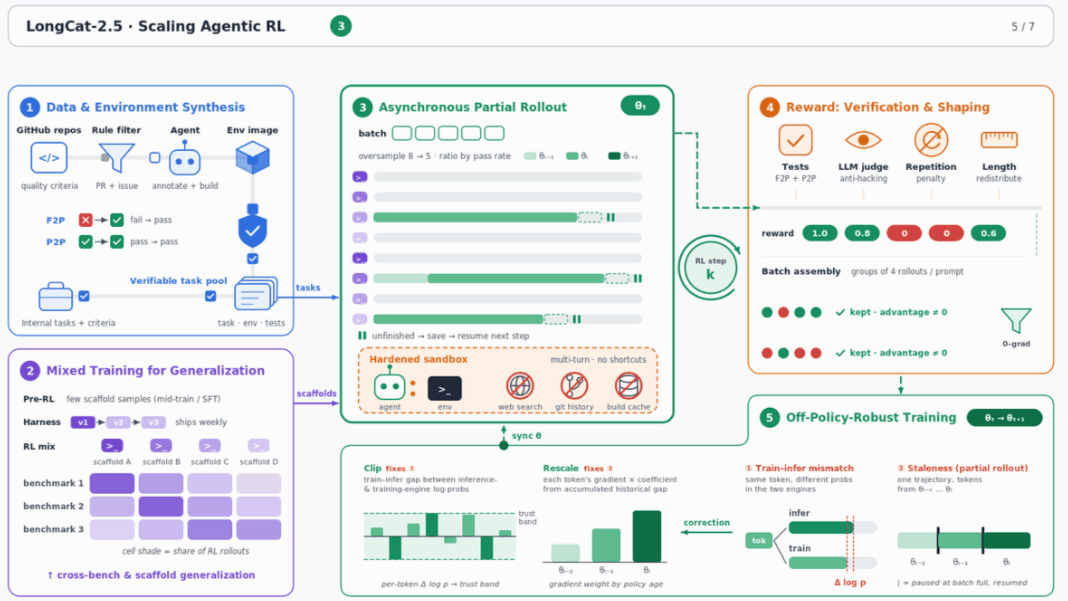
此次发布中,一个值得关注的变化是,美团将真实Agent的失败轨迹转化为可复现、可验证的训练任务,针对模型在执行中暴露的短板继续补充训练数据。
据官方介绍,LongCat-2.5在长序列训练中加入了更多长程轨迹数据,并通过大规模长程强化学习,提升端到端工程能力。
训练任务来自GitHub公开仓库和内部真实代码场景。
团队对筛选后的PR及关联issue进行自动打标、环境合成和测试校验,再利用强化学习过程中产生的执行轨迹与任务通过率,继续筛选数据、修正测试用例。
这意味着,Agent执行中的失败,以及测试本身出现的误判,都会成为后续调整训练的依据。
为了限制模型钻奖励机制的空子,美团还披露了一组具体措施:
在任务环境中断网、清除Git历史和文件缓存,并引入大模型裁判监督执行轨迹。
针对长任务中的无效消耗,团队对重复思考和重复工具调用施加额外惩罚,并通过调整奖励,抑制过度思考和输出长度增长过快的问题。
多模态方面,LongCat-2.5将视觉信号表示为多层级离散token,使主干模型以统一的token形式处理视觉与文本输入。
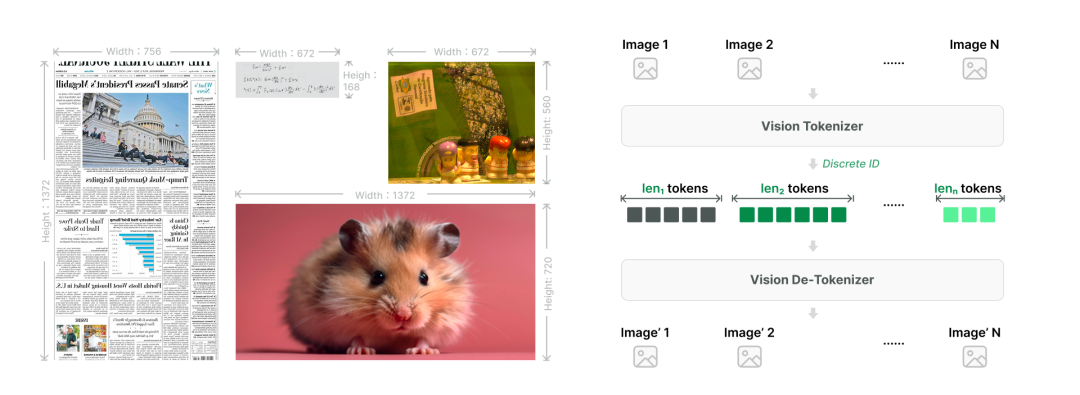
这一设计还允许团队提前离线计算、缓存图像token,减少训练时的在线视觉计算,简化长序列数据打包,并改善分布式训练的负载均衡。
视觉理解与编程能力结合后,官方展示了多种交互式网页生成案例。
其中,3D文物展览页面支持拖拽旋转、滚轮缩放、双击聚焦和线框模式切换;实时流体模拟案例则展示了动态物理效果与网页交互。
另一个活动邀请案例中,用户上传场地照片、输入自然语言需求后,模型结合照片色彩和氛围生成邀请及报名网页,并串联报名、名单查看和表格导出流程。
办公场景也在此次展示范围内,包括整合多渠道经营数据、分析利润和投入产出,以及整理客户反馈、生成支持查看原始信息的交互式HTML报告。
支撑这些能力的,还有国产算力上的训练与推理优化。
官方介绍,针对国产算力单卡显存不足80GB的限制,团队围绕超节点拓扑优化并行策略,并结合参数分片、动态专家复制和通信优化,降低显存与执行开销。
综合优化后,该FSDP配置在长序列SFT任务中的单卡吞吐量,相对DDP基线提升86%。
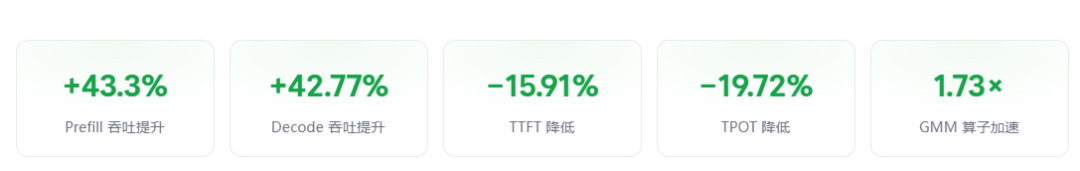
推理方面,LongCat-2.5采用W4A4方案,将专家权重与激活同时量化至4 bit。
官方称,在已评测的下游任务上,量化后保持了与量化前模型相当的表现。
在线上压测中,相对W8A8 INT8基线,Prefill和Decode吞吐分别提升43.3%和42.77%,首token延迟降低15.91%,每token生成时间降低19.72%。
在模型评测部分,美团选取GPT-5.5、GPT-5.6-Sol、Claude-Opus-4.8和Claude-Opus-5进行重点对比,并提供了覆盖更多模型的详细结果表。
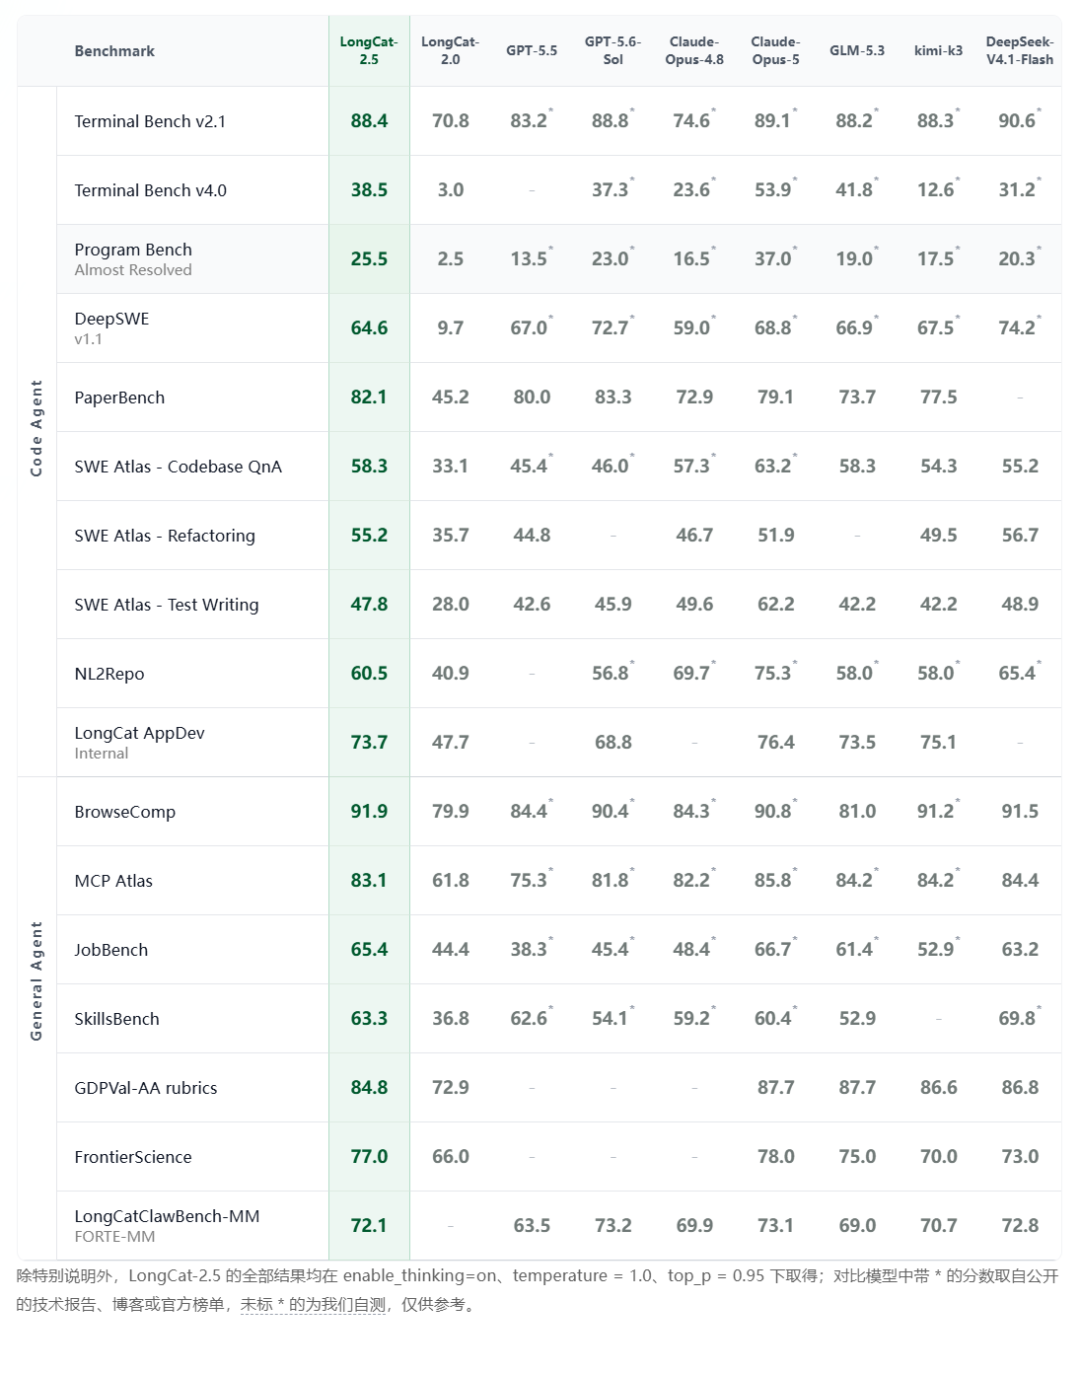
目前,LongCat-2.5已提供网页体验和API接入。
官方参数文档显示,模型支持1M tokens上下文,最大输出上限为256K tokens。
END
关注+星标,获取AI前沿进展与开源一线动态
 关注公众号
 智猩猩AI的公众号