

 2026-10-31 13:00:00


智猩猩AI整理
核心作者投稿
多模态模型已经能读出图片中的文字、识别物体、描述场景。但当一个问题需要把不同位置的信息联系起来时,模型依然容易出错。
例如,面对一张包含登机牌、航班信息屏和服务标识的图片,模型需要先读出航班号,再找到对应登机口,最后识别该登机口的服务图标。每个局部都可能看得清楚,最终答案却取决于能否把这些线索正确串起来。
类似的要求也出现在空间推理、多图理解和多模态 Agent 中:识别信息只是第一步,模型还需要判断信息属于谁、彼此有什么关系,以及哪些证据共同支持答案。
从“看清细节”进一步走向“连接证据”,正是 Zooming without Zooming v2(ZwZ2)的核心思路。
来自上海交通大学、北京中关村学院、蚂蚁集团等单位的研究团队提出了数据合成框架EvidenceConnect,通过单张图像中的多区域组合问题,训练模型寻找、关联和整合视觉证据。
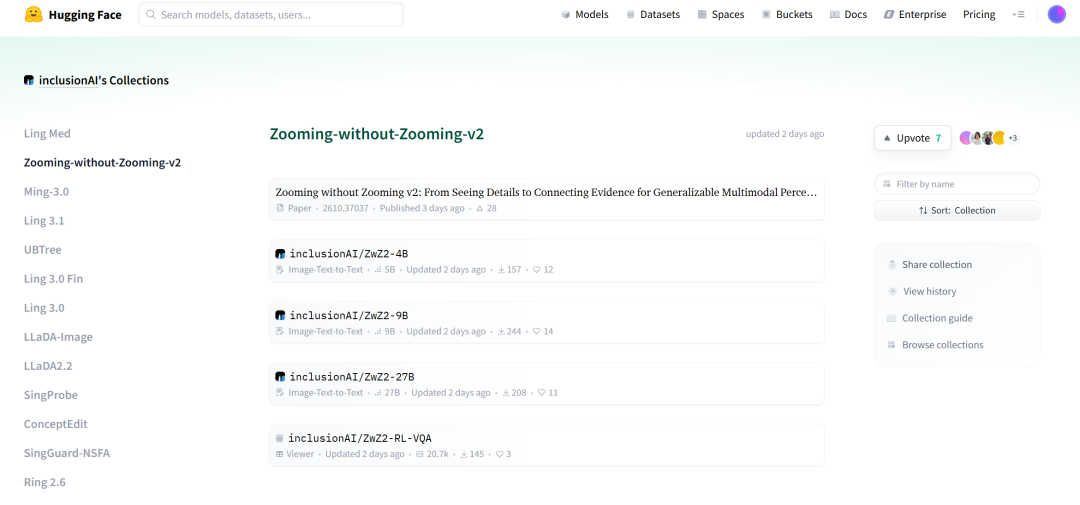
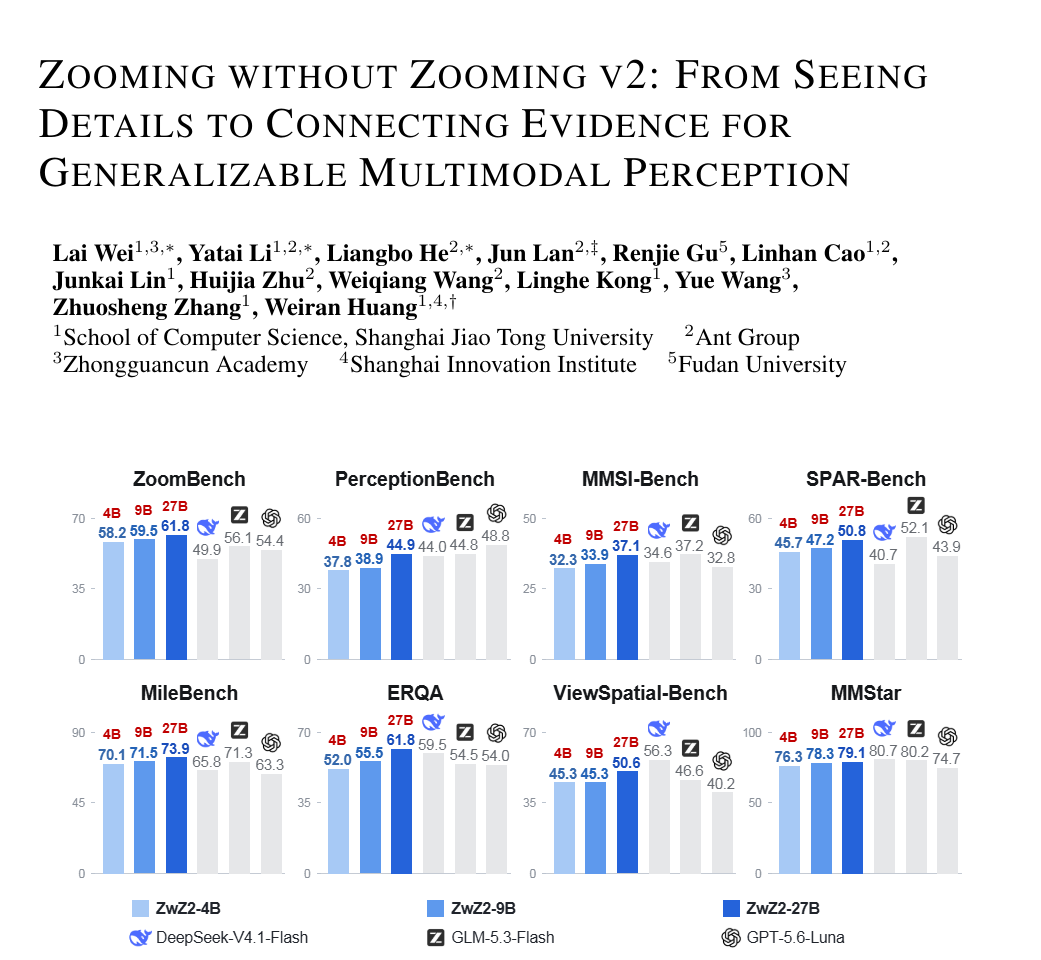
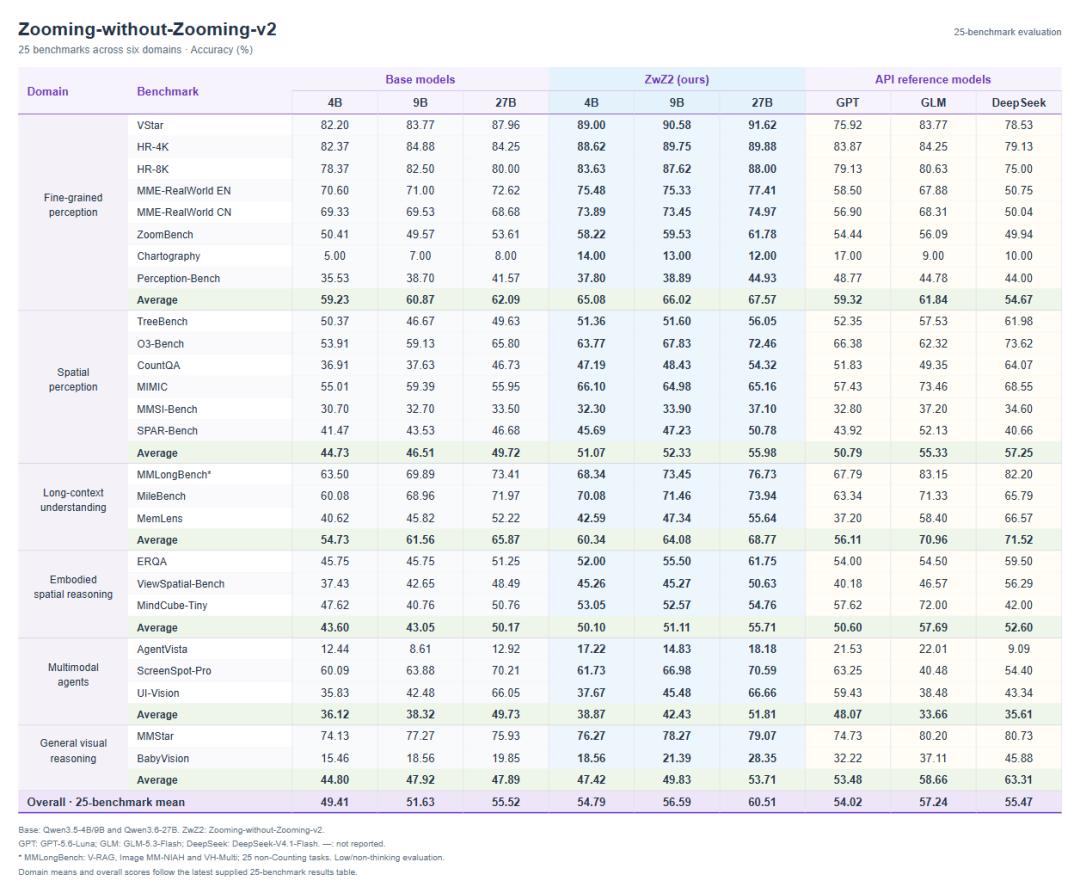
只使用20.4K 条单图训练样本,研究者就获得了 ZwZ2-4B、ZwZ2-9B 和 ZwZ2-27B 三个模型。实验覆盖六大领域、25 个基准,三个规模的模型在全部 25 个基准上,均超过各自的基座模型。相关模型已开源。
更值得关注的是,训练数据仅涉及单张图像,收益却延伸到了多图长上下文、具身空间推理和多模态 Agent 任务。
arxiv id:2610.37037
GitHub repo:inclusionAI/Zooming-without-Zooming-v2
一代 ZwZ 已经展示了“训练时放大看,推理时直接看全图”的潜力:利用局部放大视图生成细粒度视觉问答,再将这些监督用于全图训练,让模型提升对微小视觉细节的感知能力。
ZwZ2 将这一思路推进到了多个区域之间的联系。
空间感知需要关联不同物体的位置与朝向;长上下文理解需要在多张图片和多轮对话之间定位信息、保持实体身份一致;多模态 Agent 则需要把过去的观察与当前的任务联系起来。
这些任务的形式不同,却包含相似的步骤:找到相关事实,将事实绑定到正确实体,恢复它们之间的关系,再整合为答案。研究团队将这种能力称为connecting evidence,即“连接证据”。
这也带来了一个数据构建思路:复杂空间环境、长序列交互的高质量训练数据很难获得,但在一张信息丰富的图片里,就可以构造需要连接多处证据的问题。
如果这种能力能够迁移,单图数据也可能帮助模型处理更复杂的场景。
01
EvidenceConnect将这个想法
变成了一套自动化的数据合成流程
首先,框架从高分辨率图像中定位候选区域,再选出3—7 个能够共同支撑一个问题的相关区域。区域需要围绕同一个任务组织起来,例如比较多个对象、汇总不同位置的数量,或沿着线索逐步寻找答案。
随后,框架将这些区域裁剪出来,构建保留相对空间顺序的高清视图,让生成模型看清局部细节,并据此设计组合问题。主要的问题形式包括:
聚合计算:整合多个区域中的数量或数值,得到总量或计算结果。
比较与匹配:检查完整候选集合,找出异常项、极值或对应关系。
依赖链推理:根据一处线索决定下一步查看什么,再逐步得到答案。
例如,下面的示意案例将“登机牌上的航班号”“信息屏上的登机口”“登机口对应的服务图标”串联起来,形成T218 → C6 → 插头图标的证据链。
这些高清裁剪视图只用于数据构建。训练时,模型接收完整图像;大多数样本通过彩色轮廓标出相关区域,减少指代歧义,具体的视觉识别和证据整合仍由模型完成。
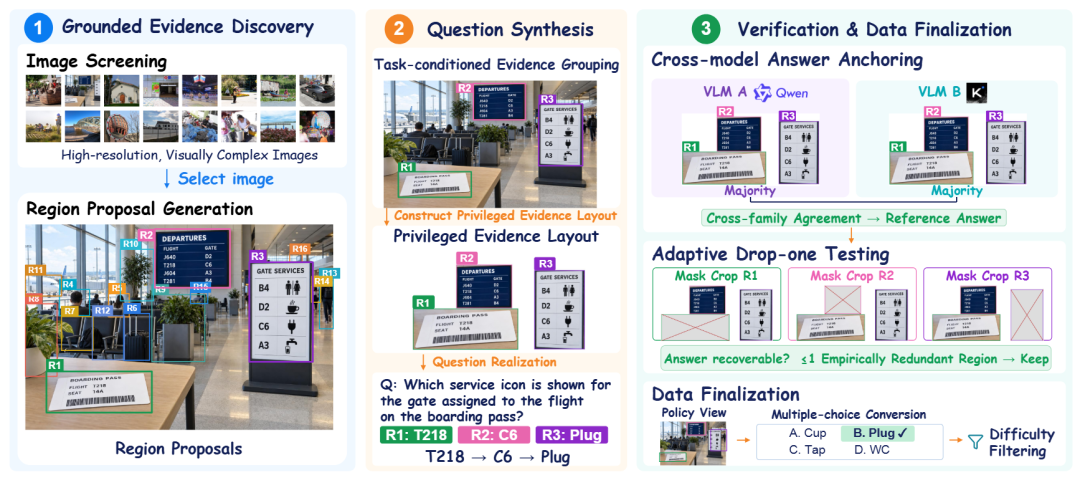
图 2|EvidenceConnect 数据合成流程。高清裁剪视图用于合成与验证,训练模型接收完整图像。
02
生成的复杂问题,还需要确认它的
答案可靠、所选证据确实有用
为此,EvidenceConnect 分别检查答案正确性与证据依赖性。
在答案验证阶段,来自不同模型家族的两个视觉语言模型独立作答,不查看生成器提供的答案或区域描述。只有双方多次回答形成一致的多数意见,候选问题才会被保留。
在证据验证阶段,框架采用drop-one 测试:每次遮挡一个区域,检查参考答案是否仍能被恢复。如果多次验证表明遮挡某一区域后仍能得到原答案,该区域就被判为经验上冗余。
考虑到相邻裁剪区域可能存在上下文重叠,以及验证模型的回答波动,框架允许一个区域被判为冗余;当两个或以上区域被判为冗余时,才丢弃该问题。
经过验证、选择题转换和难度筛选,最终得到 20.4K 条训练样本。研究者使用相同数据和训练配置,对 Qwen3.5-4B、Qwen3.5-9B 和 Qwen3.6-27B 进行基于可验证奖励的强化学习,采用 GRPO,且不经过监督微调。
实验中最突出的现象,是单图训练带来的跨任务收益。
在全部 25 个基准上的平均准确率分别为:
4B:49.41% → 54.79%
9B:51.63% → 56.59%
27B:55.52% → 60.51%
这些基准覆盖细粒度感知、空间感知、多模态长上下文理解、具身空间推理、多模态 Agent 和通用视觉推理六个领域。
以 4B 模型为例,ZwZ2 在多图长上下文基准MileBench上从60.08%提升至 70.08%,提高 10 个百分点;在ViewSpatial-Bench上从37.43%提升至 45.26%,提高 7.83 个百分点。
27B 模型在具身推理基准ERQA上,从51.25% 提升至 61.75%,提高 10.50 个百分点。在多模态 Agent 基准AgentVista上,三个规模的模型也均获得提升。
这些结果支持了论文的核心判断:在单张图片中学习连接证据,能够迁移到证据分散在多张图片、不同交互步骤中的任务。
在论文报告的对照实验中,ZwZ2-27B 的 25 项基准平均准确率为60.51%,高于 GPT-5.6-Luna、GLM-5.3-Flash 和 DeepSeek-V4.1-Flash 对应的54.02%、57.24% 和 55.47%。这一比较基于论文中的低思考或非思考模式设置,对照模型的输入分辨率同时受到平台限制。
03
与一代训练数据的比较,
进一步体现了多区域证据连接的价值
与一代训练数据的比较,进一步体现了多区域证据连接的价值。
研究者在相同的 Qwen3.5-4B 基座上,使用相同 GRPO 方案,分别比较不同来源的合成训练数据。
其中,采用一代 ZwZ 的73K 条数据训练后,模型在 11 个比较基准上的平均准确率为49.86%;使用 EvidenceConnect 的20.4K 条数据,平均准确率达到 53.86%,并在其中10 个基准上取得更高分数。
也就是说,在这组受控比较中,训练样本量约为一代数据的28%,平均准确率却高出4 个百分点。
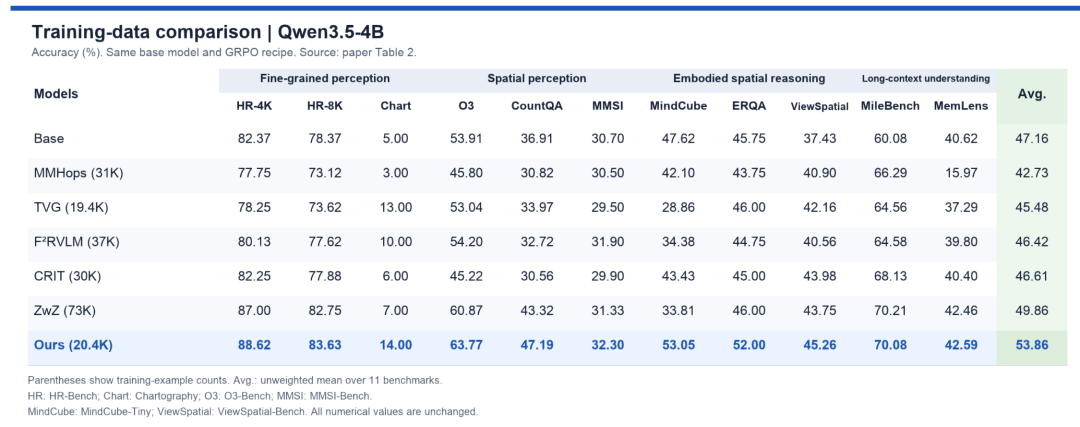
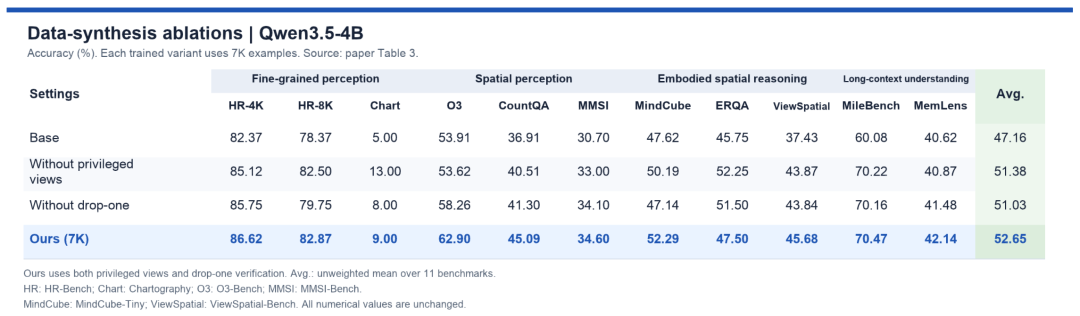
即使只使用7K 条 EvidenceConnect 样本,平均准确率也能从基座的47.16%提升至52.65%。这说明,围绕证据关系组织训练问题,可以在较小的数据规模下带来明显收益。
消融实验也支持了数据构建中两个关键环节的作用。在相同的 7K 样本规模下,使用高清裁剪视图合成数据,以及加入 drop-one 验证,都能提高下游任务的平均表现。
这种变化也体现在具体回答中。
论文展示了一个要求找出“五张图片中都出现的物体类别”的案例。基座模型选择了“酒杯”,尽管其回答已经承认部分图片中没有酒杯,实际上将“所有图片共有”放宽成了“大多数图片共有”。
ZwZ2 则排除了在部分图片中缺失的酒杯,给出了五张图片中都存在的“人”。
另一个文字识别案例中,关键在于把识别出的文字与问题指定的位置对应起来。ZwZ2 根据空间描述定位到正确的拱门区域,并读出了对应标牌上的文字。
这些案例呈现了“连接证据”的具体要求:检查完整集合、保持问题约束、将视觉事实绑定到正确位置,再形成答案。
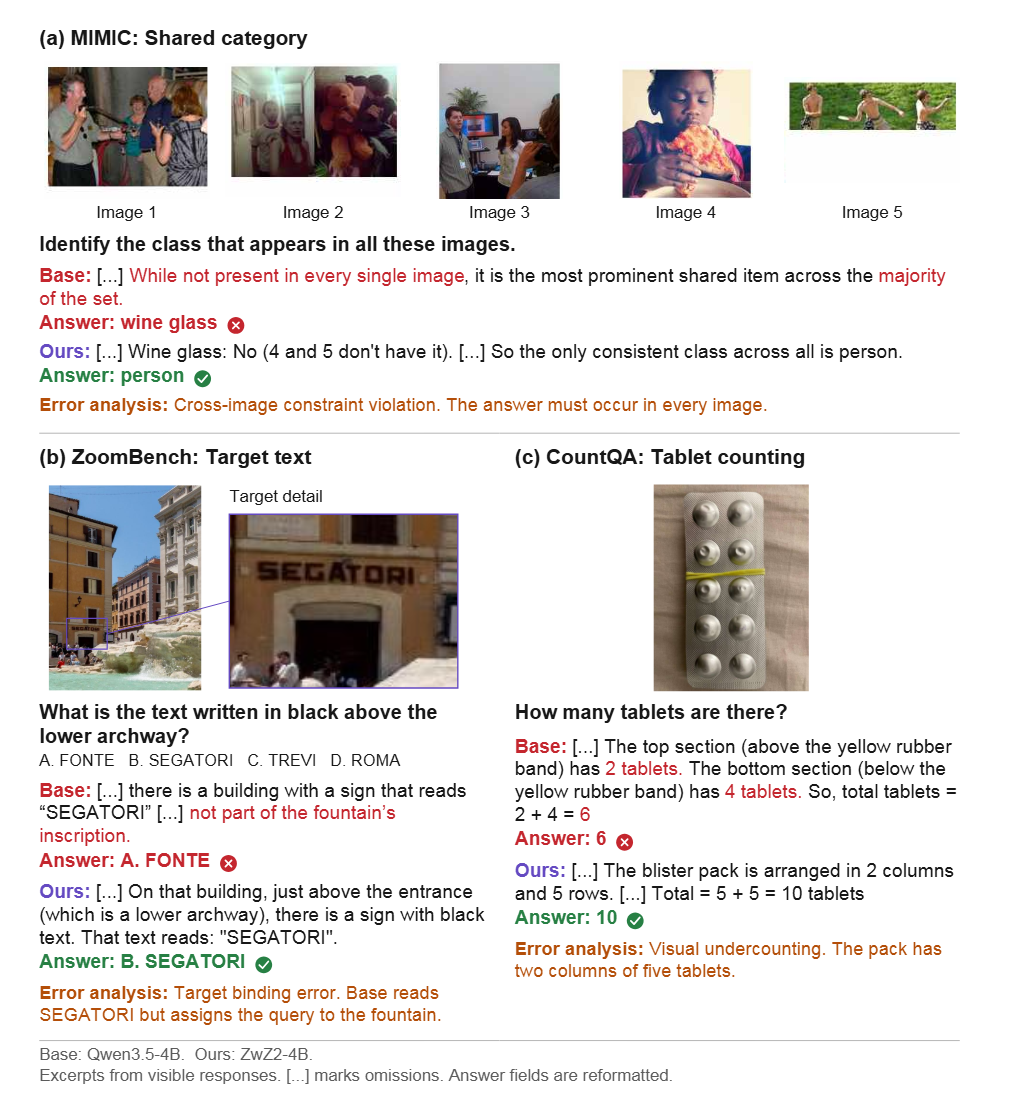
图 3|三个案例:跨图一致性、文字与位置的绑定,以及完整的物体计数。展示的是模型可见回答的节选。
ZwZ2 提供了一条值得继续探索的数据路线:将复杂任务中反复出现的证据组织方式,转化为更容易构造和验证的训练问题。
从单个区域的细节识别,到多个区域之间的比较、聚合与依赖关系,训练目标的这一扩展,让单图监督展现出了更广泛的迁移潜力。后续将这套方法扩展到视频、长序列和交互环境,也有望进一步检验“连接证据”作为共享训练目标的适用范围。
END
关注+星标,获取AI前沿进展与开源一线动态
 关注公众号
 智猩猩AI的公众号