

 2026-11-11 08:00:02


“我等新模型等到它崩了两次啊,厉娜!”
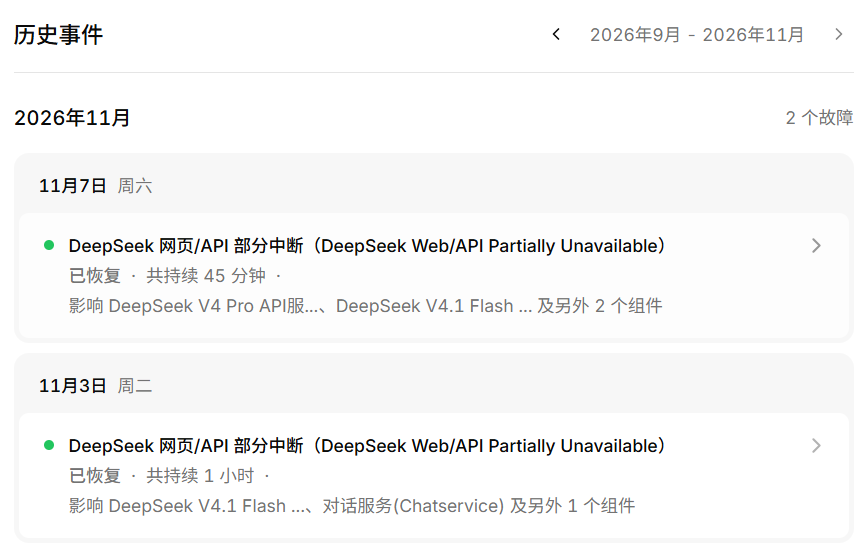
11月3日和7日,DeepSeek 网页和 API 四天内两次出现部分服务中断。
第二次故障恢复后,有用户觉得网页版 V4 Pro 变强了。紧接着,一张跑分榜传开,通过率从48%跳到64%。
有人一拍大腿:DeepSeek 该不会趁着这次故障,悄悄把 V4.1 Pro 换上去了吧?
结果,“大的”还没来,辟谣先来了。
11月9日,社交平台流传的「DeepSeek 企业咨询」账号截图里,回应只有一句:“辟谣:DeepSeek V4.1 Pro灰测为假消息”。
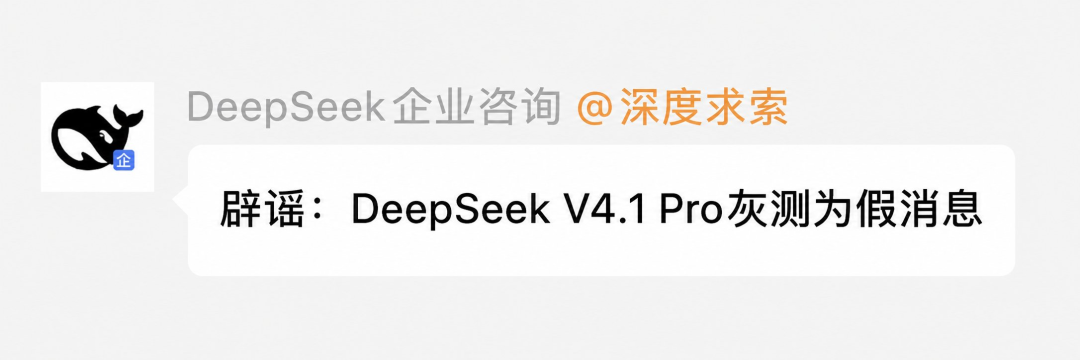
DeepSeek V4.1 Pro 仍在训练中。
印象中 DeepSeek 很少主动回应这种模型爆料,基本都是外面传得沸沸扬扬,官方依旧闷头干活。
回头看,这场乌龙的每一步都挺容易让人信。
先是服务接连出问题,11月3日16时58分,DeepSeek 网页及 API 部分中断,对话服务、V4 Pro API 和 V4.1 Flash API 均受影响,直到18时48分才标记为恢复。
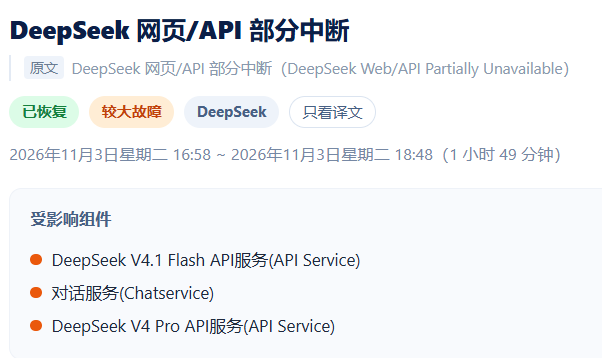
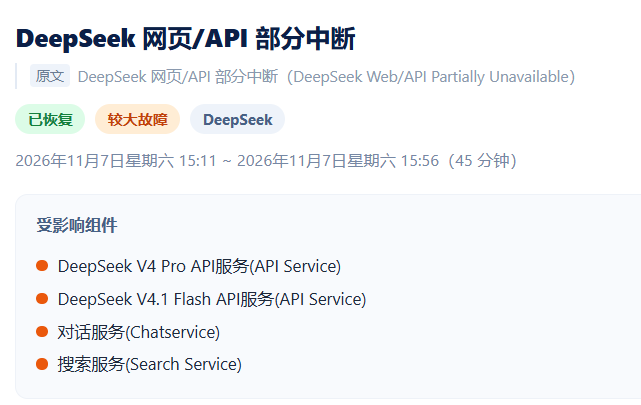
四天后,11月7日15时11分,同样几项服务又受了影响,这次故障持续约45分钟。
第二次恢复后,社区里有人拿动画渲染、鸬鹚骑自行车之类的题试模型。
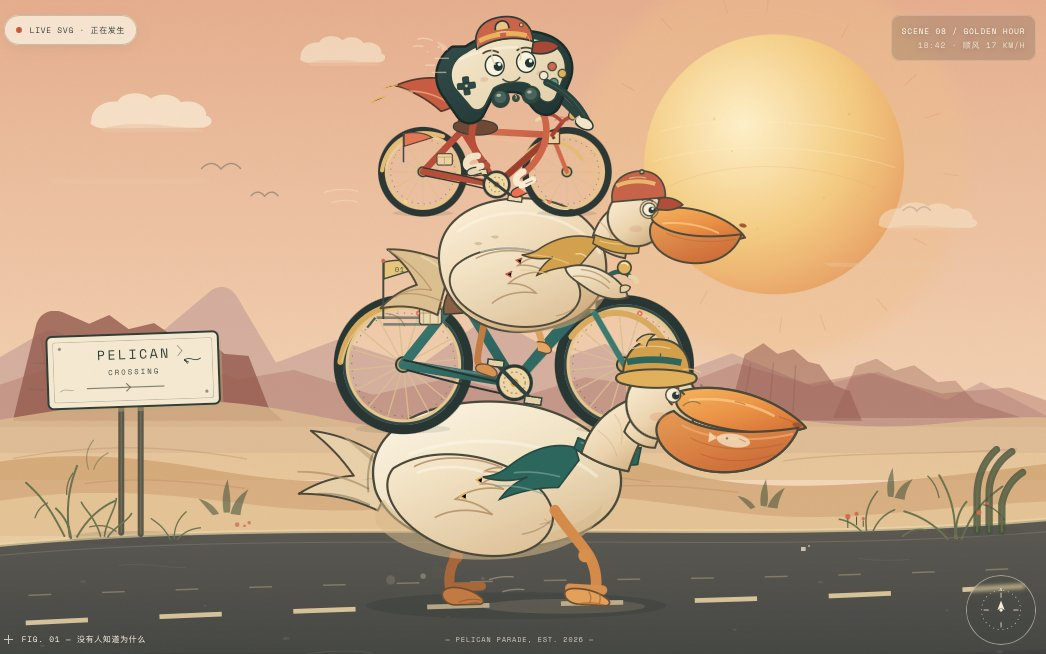
还很难让人信服。紧接着,LobeHub 开发者贴出一张50道题的对比榜单,这下看起来就像回事了。
他用内部评测集 LobeBench Hard 50,把当时的网页版 V4 Pro 和8月13日版 V4 Pro 放在一起测。
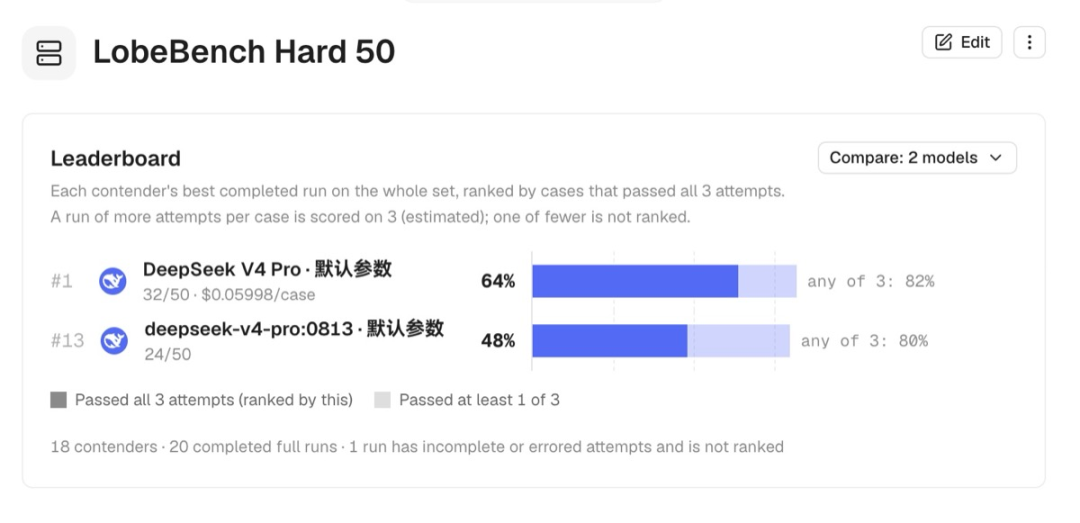
50道复杂 Agent 任务,旧版通过24道,网页版样本通过32道,足足多过了8道。
发帖时,开发者说的是疑似灰度。到了11月8日,已有报道直接写成开始灰度测试,连正式版可能一周内发布的说法也跟着传开了。
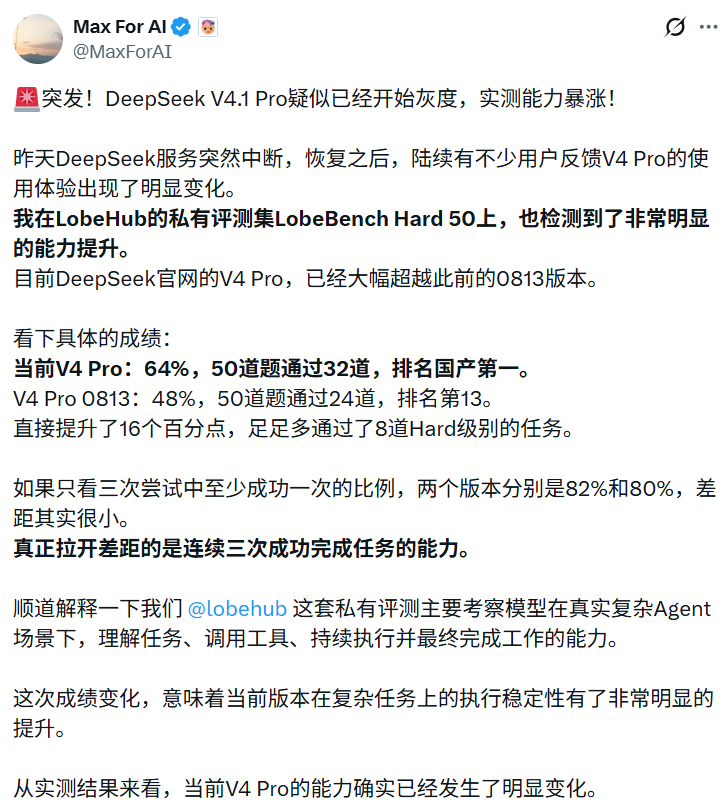
灰测闹了乌龙,可16个百分点的差距又是怎么来的?
看看这张榜单的计分规则:每道题跑三遍,三遍都做成,才给这一题记分。
比如让 Agent 修一个代码仓库,前两遍读文件、改代码、跑测试都顺顺当当,第三遍在调用工具时卡住,这道题就拿不到分。
50道题,每道做三遍。只要有一遍做成就算过,旧版过了40道,网页版过了41道,只差一道。
可榜单要求三遍都做成才算过。按这个标准,旧版过了24道,网页版过了32道,差距一下拉到了8道。
这就是48%和64%的来历:网页版在更多题上做到了三遍都成功。
模型输出、工具执行、运行环境都可能影响结果。要分清是哪一环起了作用,还得看逐题失败记录,再用相同配置复测。
至于两次故障,DeepSeek 的状态页记录了中断和恢复,并未提到切换模型。
V4.1 Pro 倒是早就在官方公告里露过面。9月10日发布 V4.1 Flash 时,DeepSeek 就提到了这个型号,10月17日实际更新的是 V4.1 Flash-1017。
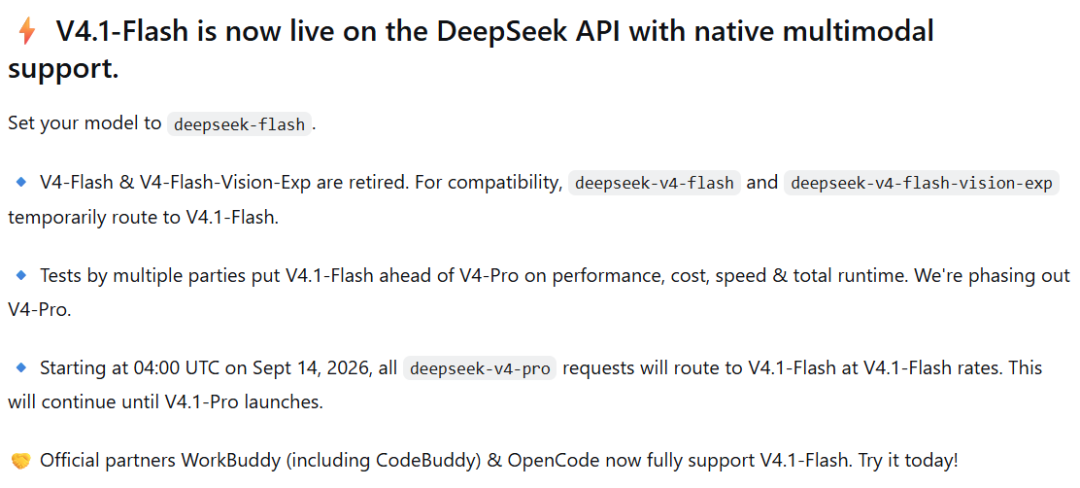
截至11月10日,官方 API 更新日志里仍没有 V4.1 Pro 的上线记录。
等了半天,新模型没等到,倒是把旧模型的计分规则看明白了。
V4.1 Pro 还得再等等啊,厉娜。
END
关注+星标,获取AI前沿进展与开源一线动态
 关注公众号
 智猩猩AI的公众号