

 2026-11-16 16:48:35


一个 Agent 做错了题,可以重试一次。但下次遇到同类问题,它还会踩同一个坑吗?
中国人民大学高瓴人工智能学院 NLPIR 团队开源的 FlashRSI,把这件事做成了可以复跑的实验。

Agent 先做题,优化端根据执行记录提出修改,再让新版 Agent 跑一批题。
改了哪段提示词、哪项技能,改完之后表现如何,都可以回头查。
11 月 9 日和 10 日,团队先后公开了 SearchQA 和 HotpotQA 的实验记录,覆盖 MiniAgent、Claude Code 两套 Harness 和 12 种自我改进方法。
项目网站上,研究者可以逐轮查看候选版本改了什么、最后选中了哪一版。
01
一行命令,
启动了什么?
FlashRSI 的官方示例,配置好环境和模型接口之后,一行命令就能启动。
flashrsi run --config examples/quickstart.yaml这条命令读取一份实验配置,里面写好了用什么算法、改哪个 Agent、用什么任务来验证。
快速入门选的是 SkillOpt、MiniAgent 和 SearchQA,共 12 道题,6 道用于训练、3 道用于验证、3 道用于测试。
实验里有两个角色。
Target 负责做题,Worker 负责看反馈、提修改。
两者可以分别配置模型。研究者可以固定做题用的模型,把变量留给 Agent 的提示词、技能和工具等资源,看看改动前后,同一个模型的表现有何变化。
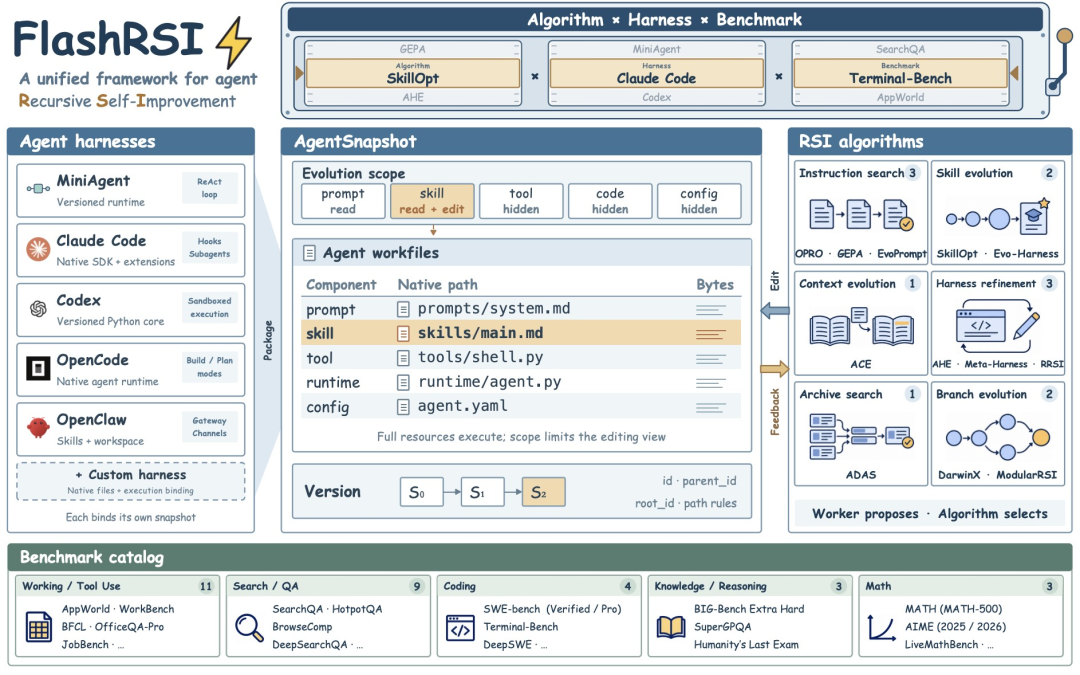
FlashRSI 给资源文件打上标签,再由算法声明自己能看、能改哪些类别。
比如,以技能为优化对象的算法,可以改技能文件,再把它放回完整的 Harness 里评测。
02
做题、改技能、再做题,
Agent 怎么从失败里学?
以 SkillOpt 为例,MiniAgent 先跑一批 SearchQA 问题,留下答案和执行轨迹。
Worker 根据这些反馈提出技能更新,后续任务就能使用更新后的技能文件。
举个例子,一道题要求先确定某个人是谁,再查证他的任职经历。
如果 Agent 搜到第一个名字就急着作答,优化端可以提出一条检索规则:
先用题目给出的线索确认人物,再单独查证任职信息。把这条规则写进技能文件,下一次碰到类似的问题,Agent 就有机会用上它。
改完以后,要看这条规则能不能在别的题上奏效。
训练题的执行轨迹用来找问题,验证题用来看候选版本的表现,测试题用来检查选中版本在未参与选版的题目上能拿多少分。
这样,研究者就能区分一次改动修好了眼前这道题,还是对同类任务也有帮助。
换一种算法,能改的地方也会变。
GEPA 可以参考得分和执行轨迹,提出新的指令版本。
SkillOpt 把修改落在可复用的技能上。
Meta-Harness 则把搜索范围扩展到 Harness 代码,让负责修改的 Agent 参考历史版本的代码、得分和执行记录,再提出新的候选方案。
一轮实验可能留下多个候选版本。有的版本在一批题上拿分更高,换一批题却会掉分。只看最终得分,很难知道中间发生了什么。
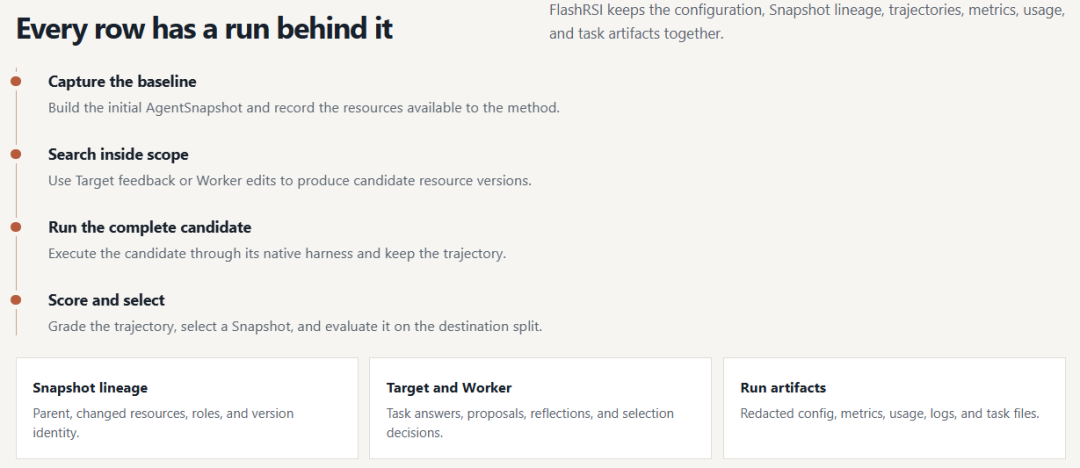
FlashRSI 为每个候选版本保存一份 Snapshot(快照),记录这个版本有哪些资源文件。
评测时,框架会恢复完整的候选版本,交给对应的 Harness 执行,并留下运行轨迹、得分和资源用量。
实验结束后,中间版本也可以单独拿出来,在另一个基准上重测。
这也是项目公开实验记录的意义。
在实验浏览器里,可以先看某一轮生成了哪些候选版本,再打开文件差异,查看哪些指令或技能描述被改过,最后回到评测记录,看这个版本跑出了怎样的结果、有没有被选中。
03
13种自我改进方法,
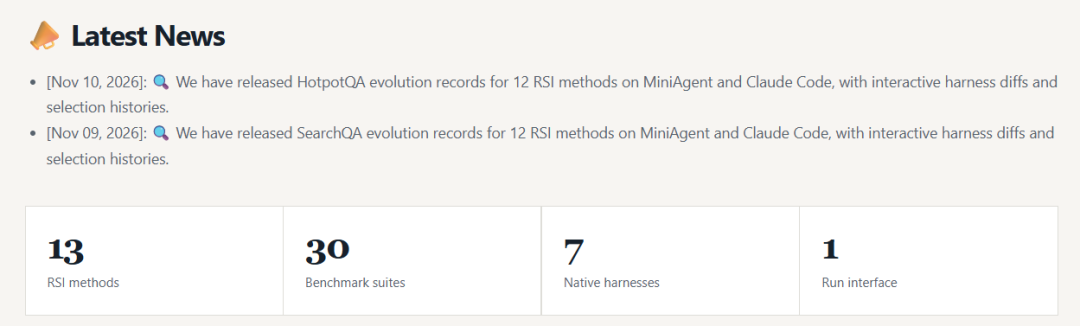
截至 11 月 16 日,FlashRSI 的 GitHub 主页列出 13 种 RSI 方法、30 个评测基准和 7 套 Harness 适配。
FlashRSI 项目页公开了 12 种自我改进方法在 Claude Code 和 MiniAgent 上的对照结果。
以 SkillOpt 为例,用它优化 MiniAgent 后,SearchQA 得分达到 82.93%,较初始版本提高 6.50 个百分点。
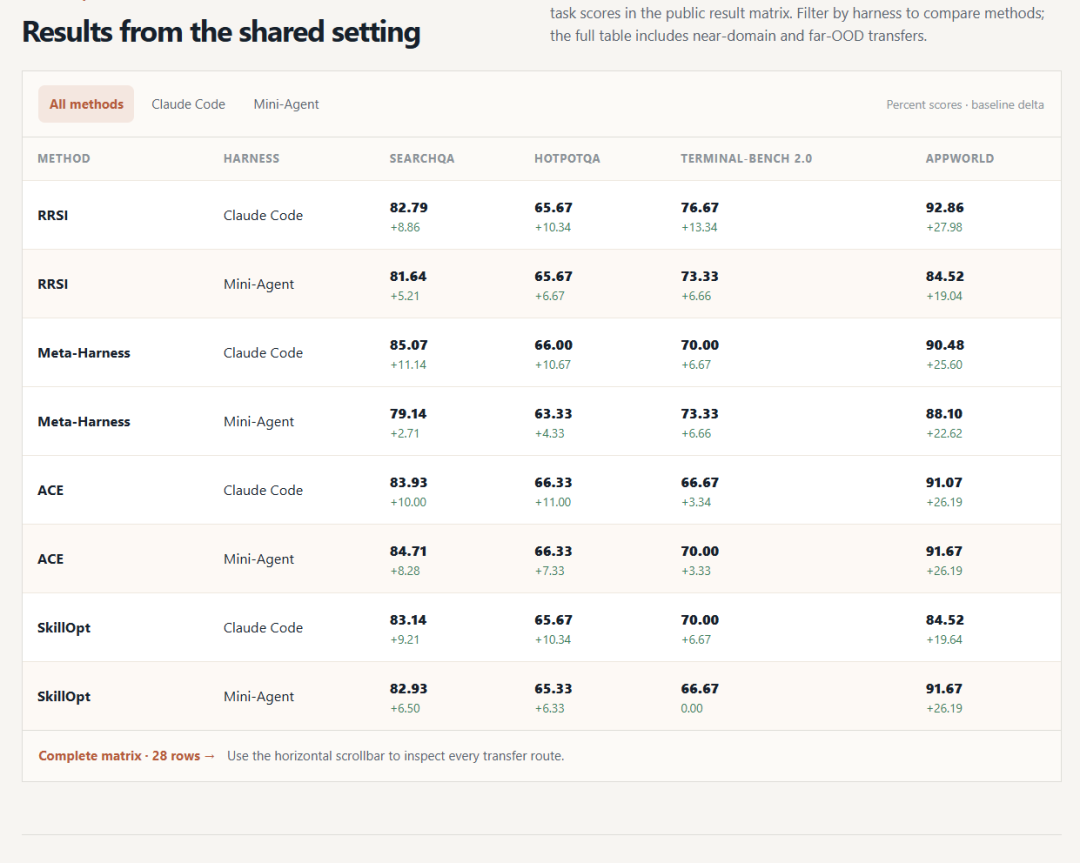
到了 AppWorld,得分达到 91.67%,提高 26.19 个百分点。
但在 Terminal-Bench 2.0 上,SkillOpt 优化后的 MiniAgent 得分为 66.67%,与初始版本持平。
换成 Claude Code,同一种算法却把得分从 63.33% 提高到 70.00%。
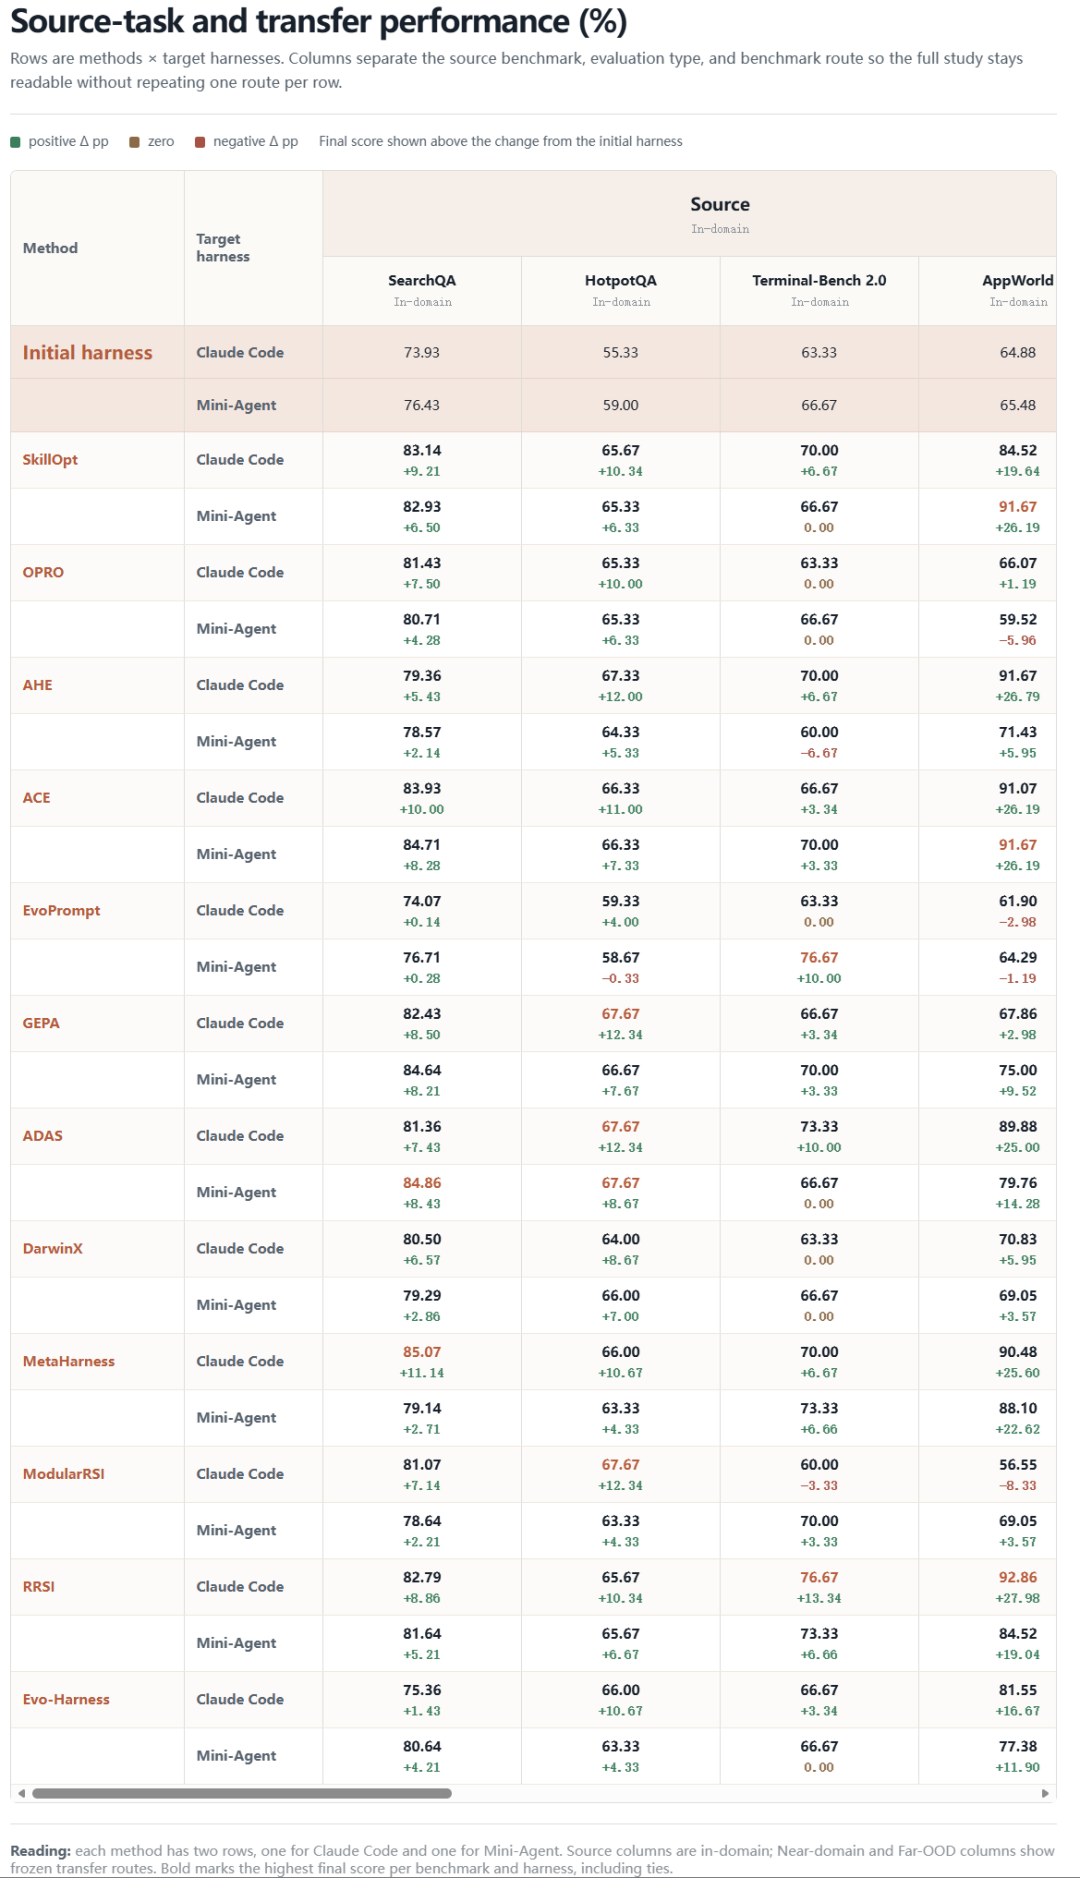
同样的任务、同样的优化算法,换一套 Harness,结果就有了差别。
如果把优化范围从技能文件扩大到整个 Harness,表现还能提升多少?
11 月初公开的 HarnessFlow 论文固定底座模型和任务环境,在每个基准上用 15 次修改尝试搜索更好的 Harness。
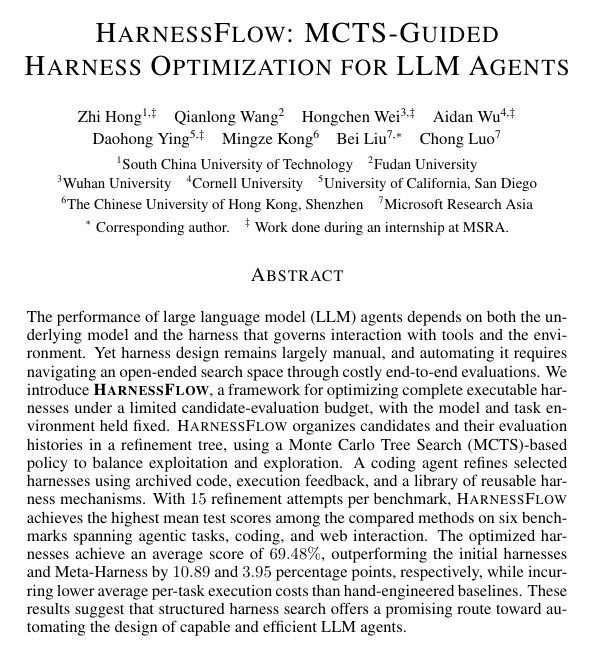
据论文报告,优化版本在六个基准上的平均得分达到 69.48%,较初始版本提高 10.89 个百分点。
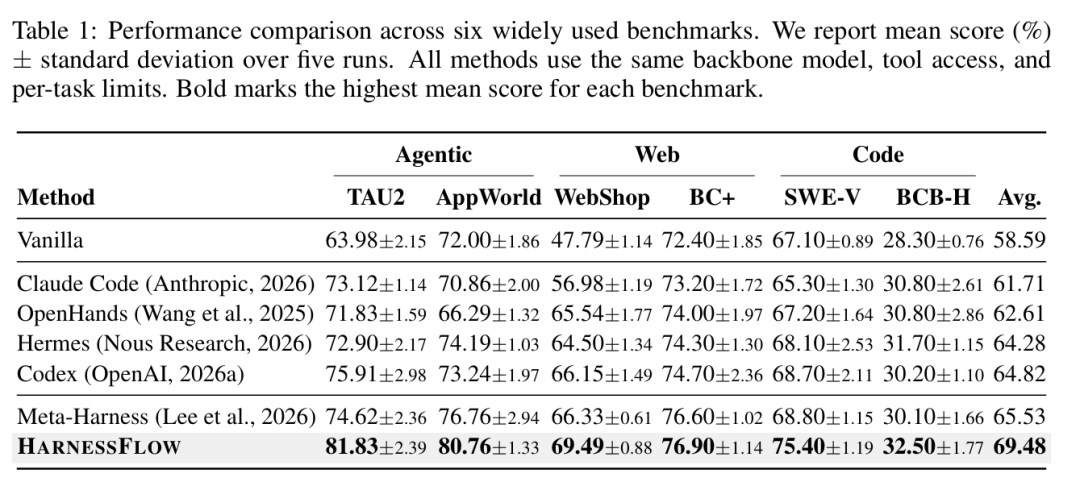
当改 Harness 也能带来这样的分数变化,能否复跑实验、核对修改,就变得和看最终分数一样重要。
一行命令把实验跑起来之后,真正值得盯的是最后那批没参与选版的题。
同一个 Agent,改过一条技能或一段指令,换道题还能做得更好吗? 有了保存下来的版本和执行轨迹,这个问题可以拿回去再跑一次。
END
关注+星标,获取AI前沿进展与开源一线动态
 关注公众号
 智猩猩AI的公众号