

 2026-11-07 10:00:02


多跳问答一直是知识库检索里难啃的问题:答案散在几份资料里,中间还隔着问题没有提到的线索。
Graph RAG 借助知识图谱,把这些关系串起来,但沿图找出的候选往往很多,再交给大模型逐一筛选,查询就容易慢下来。
现在,决策模型开始接手 Graph RAG 里的筛选工作,而且交出了超出预期的成绩。
来自 Zilliz 的开源项目 Vector Graph RAG 把 Jev 和知识图谱检索结合起来,让决策模型参与挑选证据。
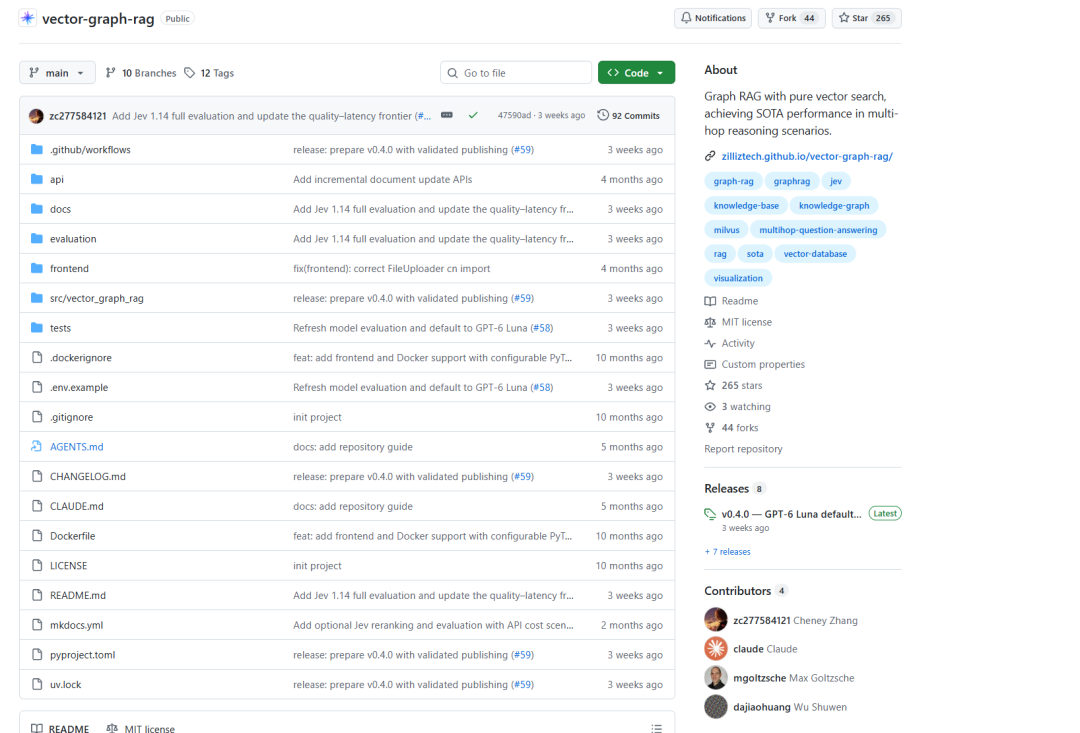
结果,这套组合在公开多跳问答数据集上,超过了参与对比的大模型重排方案,同时保持了更短的模型调用时间。
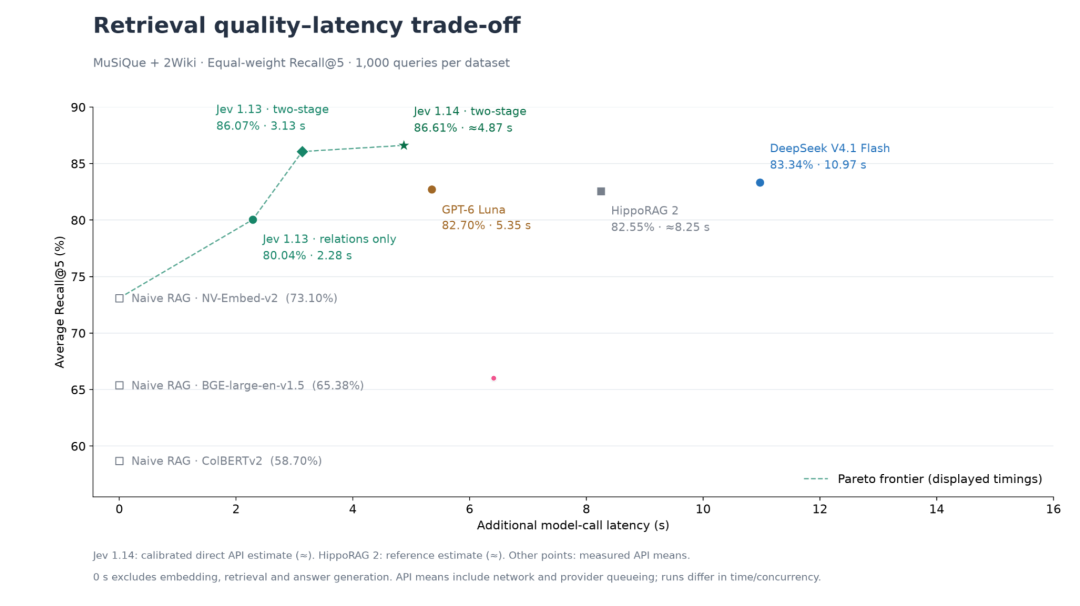
项目评测覆盖 MuSiQue 和 2Wiki 两个多跳问答数据集,各 1,000 题,检验系统能否找回分散在不同材料里的回答证据。
两阶段 Jev 1.14 达到 86.61% 的平均 Recall@5,在这组对比中召回效果最高。Jev 1.13 的召回率为 86.07%,模型调用耗时更低。
可以看到,基于 Jev 的几个方案,在效果和时延上坐标里,围成了一条「斩杀线」,更快且更准。把基于 LLM 重排都打败了。
01
从关系到原文,Jev 做两次筛选
Vector Graph RAG 做的事情,可以概括为:先顺着关系找到线索,再回到原文挑证据。
它把文档里的实体存成点,把实体之间的关系存成边,同时保留每条关系对应的原文。点、边、原文都放进 Milvus,靠向量搜索和 ID 关联完成检索,不用额外部署图数据库。
看一个简单问题:
2 型糖尿病的一线用药,有哪些需要留意的副作用?
假设知识库里有治疗指南、药物说明和研发资料。问题没有直接写出药名,系统需要先找到用药,再找到它的不良反应。从检索起点到最终原文排序的流程分为五步:
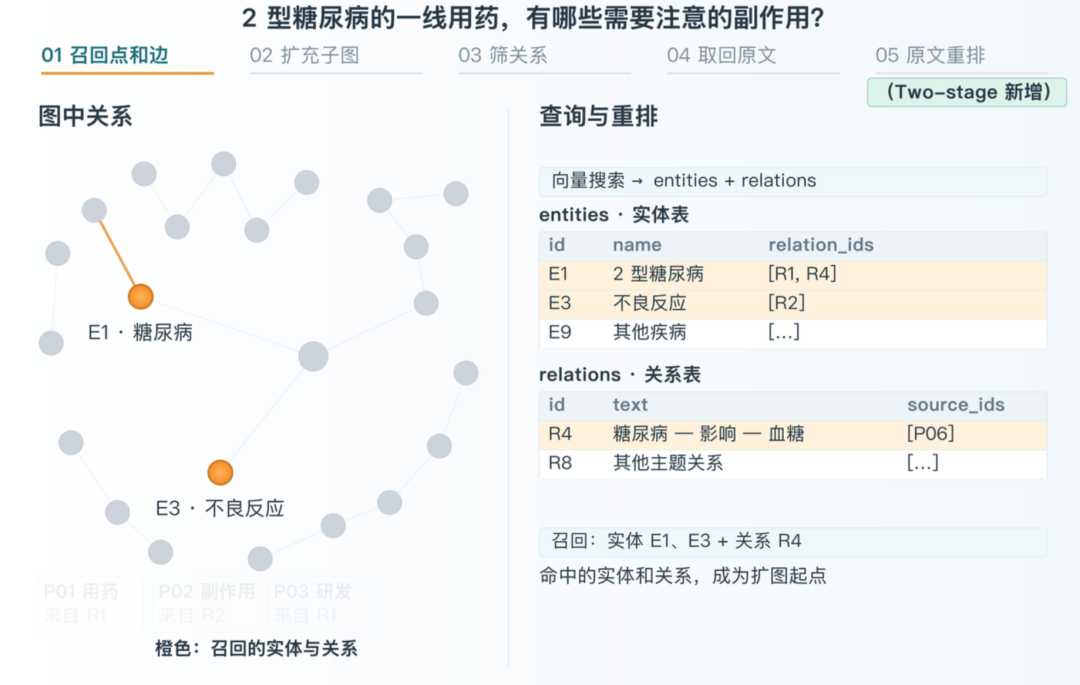
(1)找到起点。 从问题里提取实体,用向量搜索同时召回相关的实体和关系。语义相近的表述也有机会匹配,例如问题里的「副作用」和资料里的「不良反应」。
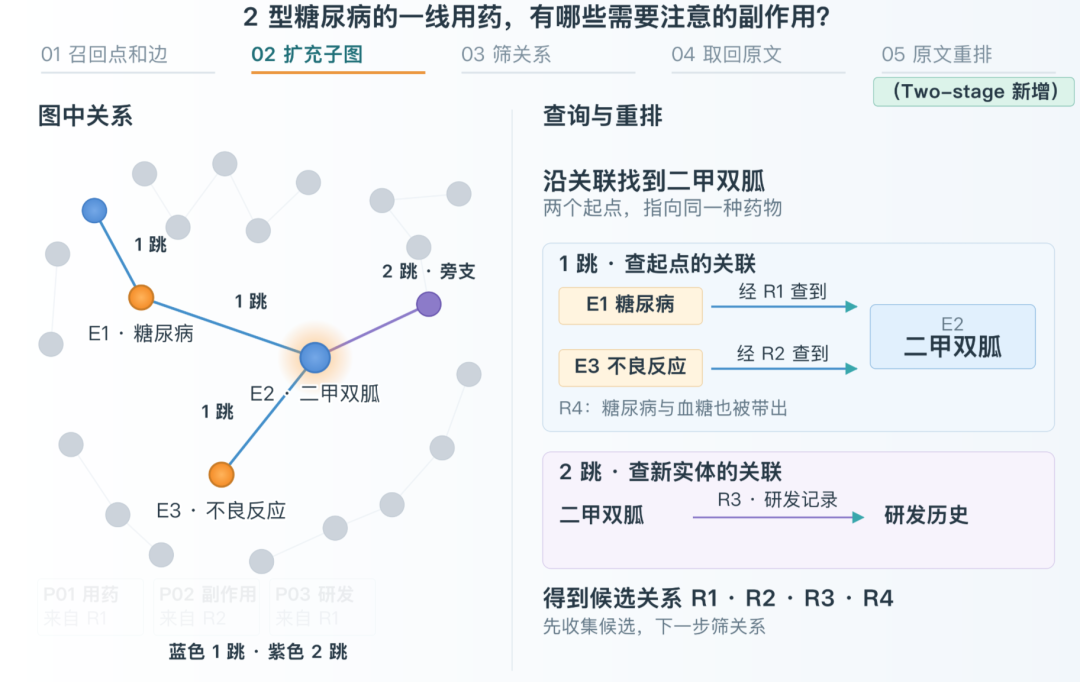
(2)扩充子图。 沿着这些点和边继续找,发现用药关系里的「二甲双胍」,再带出与它相连的其他资料。问题中没出现的名字,就这样进入了检索范围。
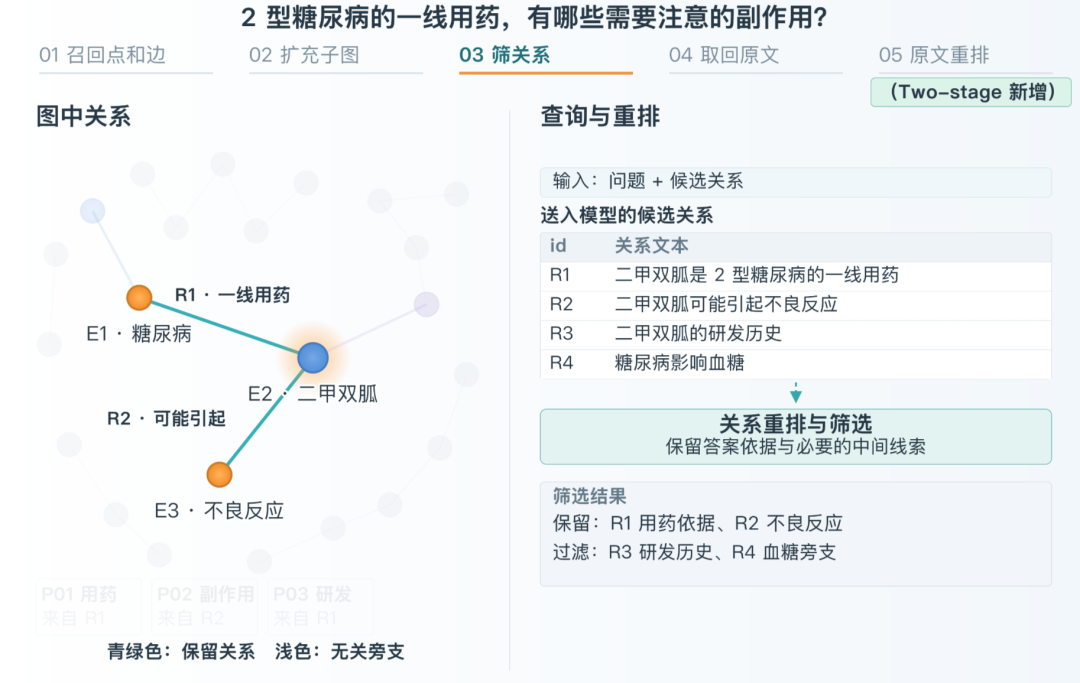
(3)Jev 第一阶段:筛关系。 扩出来的关系可能有几百条,里面混着研发、治疗、症状等线索。Jev 判断哪些关系有助于回答问题,留下有用的连接。
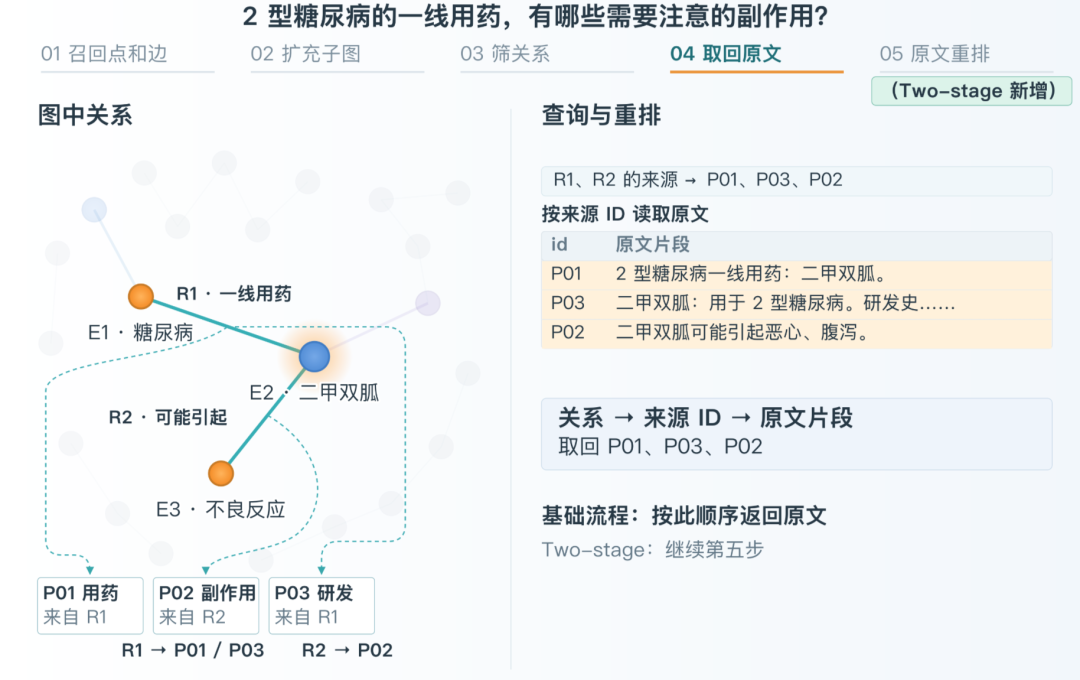
(4)取回原文并合并。 根据留下的关系找到来源片段,同时补入直接向量检索命中的原文,再去重。这样既能沿图找资料,也能接住图里没表达好的信息。
(5)Jev 第二阶段:排原文。 同一条用药关系可能出现在治疗指南里,也可能出现在很长的研发史里。Jev 阅读候选片段,把真正涉及副作用的材料排到前面,再交给回答模型。
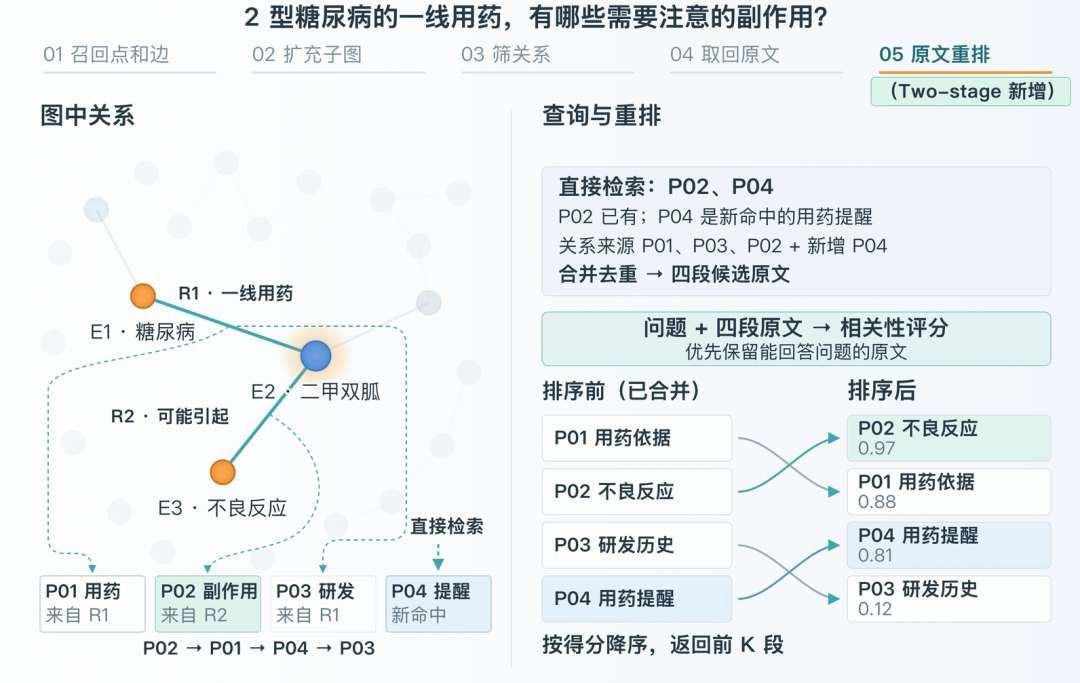
两阶段各负责一个判断:哪些关系值得跟下去,哪些原文值得拿来回答。
Jev 对候选项做判断和打分,程序按分数筛选、排序,省去了生成一长段重排结果的过程。
这里的两阶段指两个处理环节,候选多时会分批请求。建库时抽取实体关系,以及最后组织自然语言答案,仍由生成模型完成。
02
快速开始
(1)安装 Python 包
准备 Python 3.12 和 uv,在一个新目录里创建项目:
uv init --python 3.12 jev-democd jev-demouv add vector-graph-rag
默认使用 Milvus Lite,数据保存在本地文件中。数据量较大时,也可以连接 Milvus Server 或托管的 Zilliz Cloud。
(2)配置密钥
在项目目录创建 .env:
VGRAG_OPENAI_API_KEY=your_openai_api_keyVGRAG_JEV_API_KEY=your_typesafe_api_key
OpenAI 密钥用于文本向量、实体关系抽取和最终回答;Typesafe 密钥用于 Jev 的关系筛选和原文重排。程序会自动读取当前目录的配置。
(3)导入资料,直接提问
新建 demo.py:
from vector_graph_rag import VectorGraphRAGrag = VectorGraphRAG(milvus_uri="./demo.db",collection_prefix="jev_demo",reranker_model="jev-1.13.0", # or jev-1.14.0)rag.rebuild_texts(["星河 A1 支持离线使用。星河 B2 需要联网才能使用。","星河 A1 的保修期为三年。星河 B2 的保修期为一年。",])result = rag.query("哪些支持离线使用的产品,保修期超过两年?")print(result.answer)print(result.passages)
运行:
uv run python demo.pyrebuild_texts() 用于完整建库,会重建同名知识库。资料导入一次后,后续运行可以去掉这段,只保留初始化和查询;数据仍保存在 demo.db 中。
(4)导入自己的 PDF、Word 或 Markdown
有自己的文档,可以直接用文件导入器跑完整个流程。先补装文档解析依赖,沿用上面的 .env 配置:
uv add "vector-graph-rag[loaders]"把资料放进项目的 docs 目录,新建 query_files.py。下面的文件名和问题换成自己的即可;Word 文档使用 .docx,旧版 .doc 建议先另存为 .docx。
from vector_graph_rag import VectorGraphRAGfrom vector_graph_rag.loaders import DocumentImporterimporter = DocumentImporter(chunk_size=1000, chunk_overlap=200)loaded = importer.import_sources(["./docs/product-manual.pdf","./docs/warranty.docx","./docs/faq.md",])if loaded.errors:raise RuntimeError("\n".join(loaded.errors))if not loaded.documents:raise ValueError("No text was extracted from the documents.")rag = VectorGraphRAG(milvus_uri="./documents.db",collection_prefix="my_docs",reranker_model="jev-1.13.0",)rag.rebuild_documents(loaded.documents, extract_triplets=True)result = rag.query("哪些支持离线使用的产品,保修期超过两年?")print(result.answer)print(result.passages)
运行:
uv run python query_files.py导入器负责读取文件、提取文字并分块,rebuild_documents() 完成实体关系抽取和向量入库,query() 接着完成检索、两阶段 Jev 重排和回答。
可选:REST API 和可视化前端
需要让其他服务通过 HTTP 调用时,再安装 API 依赖并启动服务:
uv add "vector-graph-rag[api]"uv run uvicorn vector_graph_rag.api.app:app --host 127.0.0.1 --port 8000
API 服务读取自己的配置。在同一份.env中增加 VGRAG_RERANKER_MODEL=jev-1.13.0 即可启用两阶段 Jev。接口提供资料导入和查询,启动后访问 http://127.0.0.1:8000/docs 查看参数并试用。
项目还带有可视化前端,用于查看子图扩展、关系筛选、来源原文和回答:
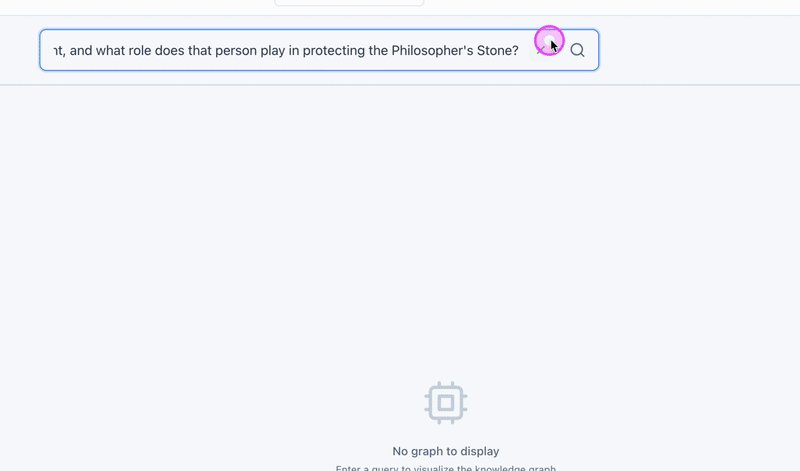
需要界面时,下载项目源码,在 frontend 目录执行 npm ci 和 npm run dev,再打开默认地址 http://localhost:5173。前端依赖上面的 API 服务;直接用 Python 包的应用可以跳过这部分。
03
让多跳检索更实用
Vector Graph RAG 在向量数据库中连接分散的知识,省去了额外维护图数据库的负担。Jev 加快了筛选和重排,让多跳检索在效果与速度之间有了更好的选择。
这个项目也展示了决策模型一个值得继续探索的用途:在需要从大量候选中做选择的环节,用更轻量的判断提升检索效率。
感兴趣的话,可以从几份需要交叉查阅的文档开始,问一个普通向量检索经常漏掉线索的问题,看看它能否找齐证据,以及这样的速度是否满足业务需求。
END
关注+星标,获取AI前沿进展与开源一线动态
 关注公众号
 智猩猩AI的公众号