

 2026-11-07 12:00:01


让 Agent 完成越来越多的任务,并不意味着它在持续进化。
真正重要的是,如何让分散的任务反馈,沉淀为能够共享、组合和持续演化的能力。
近日,来自InfRec、西安电子科技大学、同济大学、新加坡国立大学等机构的研究者提出多模态递归自我改进框架 The Trinity,尝试围绕不同任务共享的能力需求,组织环境生成与Agent演化。
它的核心思路是:将RSI的基本演化单位从“任务”转向“能力”,让分散在不同任务中的改进能够被共享、继承和继续优化。
经过四轮RSI,论文主实验中28个训练基准和18个未见基准的平均得分分别提升34.1分和26.2分,并在两个真实机器人任务上初步展示了迁移潜力。
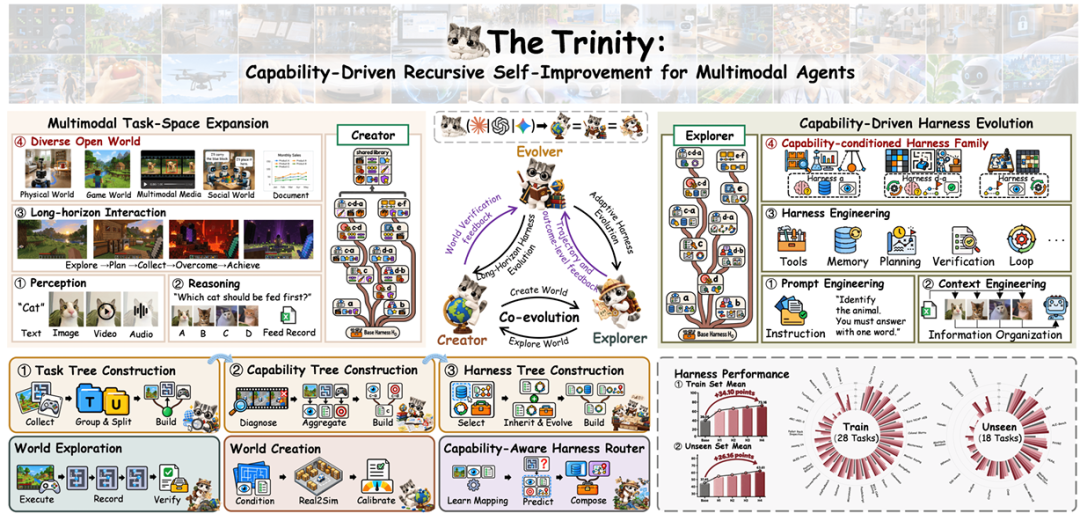
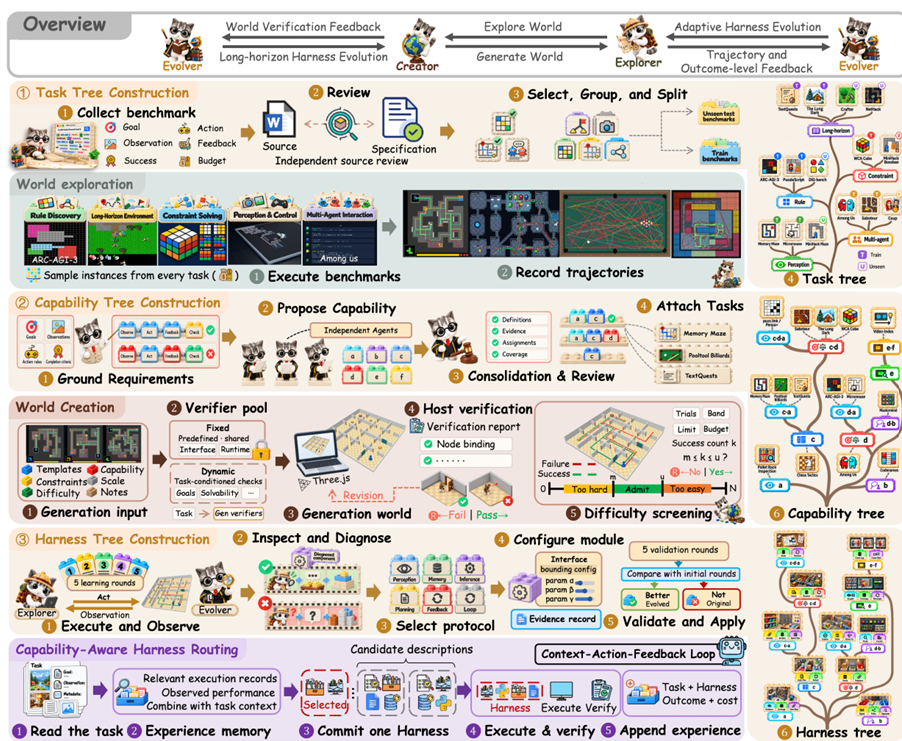
图1 The Trinity总体框架:环境生成与能力驱动的Harness演化
给Agent一个任务,让它执行、获取反馈、修改策略,再执行一遍,是递归自我改进的常见思路。
但当任务从代码和文本扩展到交互游戏、视频理解、导航与机器人操作时,困难也随之增加:
环境越来越难构建和验证,提示词、记忆、工具调度与执行流程也越来越难靠人工逐一优化。
即使这些工作都能自动完成,还有一个问题需要回答:
系统为一百个任务生成了一百套更好的解决方案,这些改进之间,能否建立联系?
The Trinity将这个问题放到了方法设计的中心。
01
从任务到能力,
让不同任务的经验接上来
在多模态任务中,表面形式不同,底层能力需求却可能相通。
例如,ARC-AGI-3要求Agent识别网格状态及其变化,Micromouse要求Agent在迷宫探索中持续更新环境信息。两者的任务形式不同,却都依赖准确的感知与状态追踪。
一个任务可能需要多种能力,同一种能力也可能服务于多个任务。
沿着这个思路,The Trinity先收集不同类型的任务,构建Task Tree,再让初始Agent执行这些任务,记录可验证的交互轨迹。
随后,系统结合任务定义与实际执行过程,分析任务需要哪些能力、失败发生在哪些决策环节,并据此构建Capability Tree。
树上的路径表示一组能力需求。来自不同领域的任务,只要共享这些需求,就能够在同一组织结构中建立联系。这也改变了Harness的优化方式。
Harness可以理解为围绕基础模型组织感知、记忆、推理、规划、工具调度与执行的运行框架。
针对单个任务优化,容易积累出彼此孤立的配置;把所有经验放进一个统一Harness,又可能让不同任务的需求相互干扰。
能力树提供了另一种组织方式:
共享的需求用于积累通用模块,差异化的需求则交给不同分支继续优化。
由此,经验有了明确的继承关系,后续改进也有了可以接着往前走的起点。
02
环境与Agent一起改进,
沿着能力树积累模块
围绕能力组织经验之后,训练环境也需要与这些能力对应起来。
The Trinity通过三个角色完成这一过程:
Creator负责构建可交互、可验证的模拟环境。
Explorer负责执行任务,产生交互轨迹。
Evolver负责分析任务需求与执行反馈,指导环境和Harness的改进。
三个角色使用固定的基础模型,演化主要发生在Harness层面。
其中,环境生成采用了Capability-Driven Real2Sim2Real:从原始任务中提取共同的能力需求,将其转化为简化的模拟训练环境,再回到原始任务上检验迁移效果。
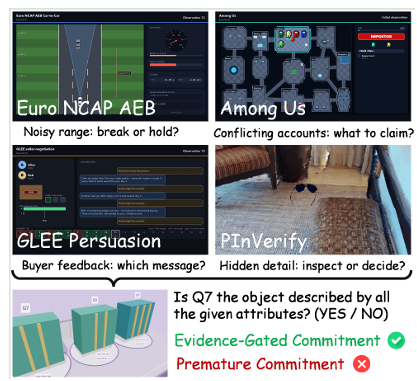
例如,多个任务都要求Agent在行动前确认信息是否充分,训练环境就可以围绕“获取证据—检查条件—决定是否行动”这一过程展开。
环境设计优先保留需要学习的决策机制,并减少无关的场景复杂度。
生成的环境还需要经过验证和难度筛选。
环境中的执行反馈用于改进Explorer;环境构建中的验证失败,则推动Creator修正自己的Harness。
这让环境生成与Agent改进形成了相互推动的循环。
在Harness演化过程中,Explorer沿着能力树逐节点学习。每个节点都可以选择性继承父节点已有的模块,并根据本节点的反馈修改或增加模块。
随着能力需求增加,系统可以在已有配置上继续改进。
不同分支也能够保留各自的专业化配置,共同形成一棵Harness Tree。
Creator则会在每轮结束时整合经过验证的模块更新,用于下一轮环境构建。
这些专业化配置最终还需要被用到合适的任务上。
为此,The Trinity引入了 Capability-Aware Harness Router。
它根据任务公开信息、候选Harness的能力描述,以及过去经过验证的执行经验,选择适合当前任务的配置。
这样,整个流程就连了起来:任务提供能力需求,环境提供训练反馈,模块保存已有改进,Router负责将这些改进应用到新的任务中。
03
RSI收益能否延续到未见任务?
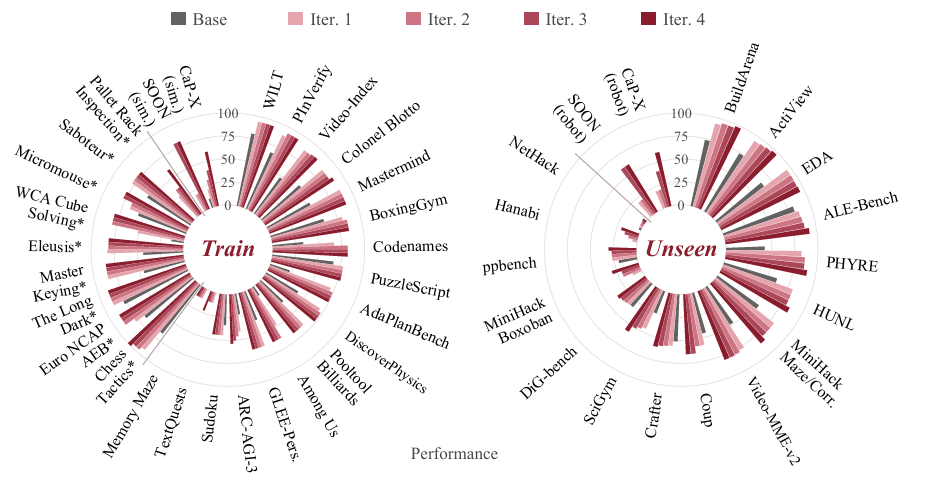
研究团队在28个训练基准和18个未见基准上进行了评测,覆盖规则发现、约束求解、感知与控制、多智能体交互和长程任务等场景。
四轮迭代中,基础模型、能力类别与能力树结构保持固定,系统持续更新模块与Harness配置。
第一轮带来了最大的提升,后续三轮仍然继续提高了训练集与未见集的平均表现。
这些结果表明,在当前实验范围内,系统能够沿着固定的能力树继续积累有效改进,收益也延伸到了训练之外的任务。
能力组织与模拟环境各自带来了什么作用,论文也进行了对照。
在不加入Skill的首轮实验中,同一能力树使用原始任务训练时,训练/未见得分为53.44/42.31;换成围绕能力生成的模拟环境后,提高到 56.95/47.26。
模拟环境方案的首轮训练成本更高,但环境可以在后续迭代中复用,其评测阶段的推理token消耗也更低。
这些结果支持了一个核心判断:聚焦共同决策机制的简化环境,也能为跨任务迁移提供有效的训练信号。
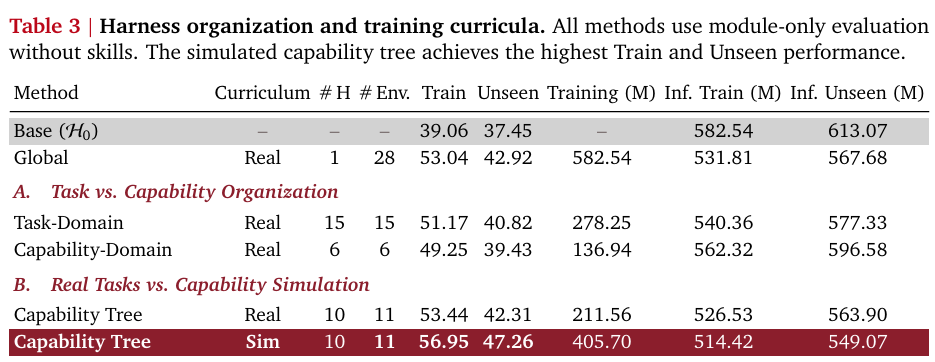
表1首轮、无Skill设置下的Harness组织方式与训练环境对照
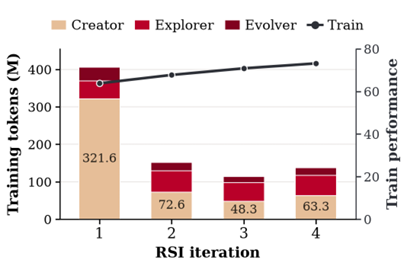
图5 四轮RSI中的训练token消耗与训练集表现
专业化之后,能否选对Harness同样重要。
仅根据公开任务信息和接口描述进行选择时,Agent在未见基准上的平均得分为52.36;加入能力信息与执行经验检索后,完整Router达到 60.96。
其训练集得分为71.27,已接近Oracle参照的73.16/63.61。
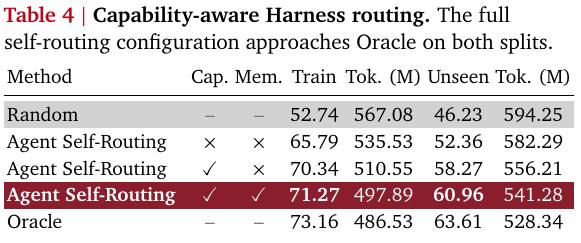
表2 能力信息与执行经验检索对Harness自主路由的作用
能力信息也能帮助模块选择。研究团队分析了第四轮演化后的29个模块与六类能力之间的关系,并通过模块添加、移除实验进一步验证。
在初始Harness中加入与任务需求相关的模块,训练平均得分提高19.39分;加入无关模块,仅提高1.02分。移除演化配置中的相关模块,则会带来性能下降。
这些结果为“按照能力需求选择和组合模块”提供了实验依据。
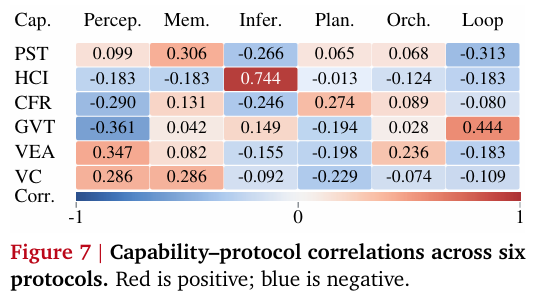
图6 六类能力与六个Harness协议的关联;红色为正相关,蓝色为负相关
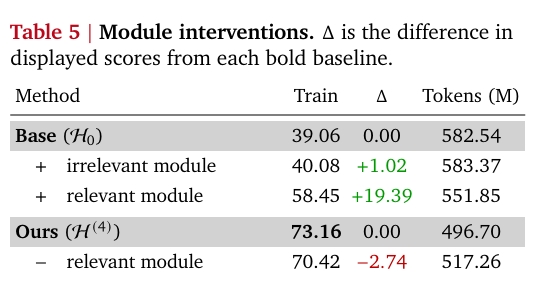
表3 添加和移除相关模块对训练集得分及推理开销的影响
研究团队还将演化后的Harness用于两个真实机器人任务。
在SOON中,Unitree G1需要找到办公室里风扇旁的目标桌子,并移动到可以触及的位置。
在CaP-X中,AlohaMini2需要检查倒扣的杯子,判断是否藏有方块,并报告其颜色与位置。
团队先在重建的模拟环境中准备任务Skill,再固定配置进行真实机器人测试。
在两项各10次的正式测试中,演化后的Harness与Skill组合都将成功率从 0%提高到60%,即从0次成功提高到6次成功。
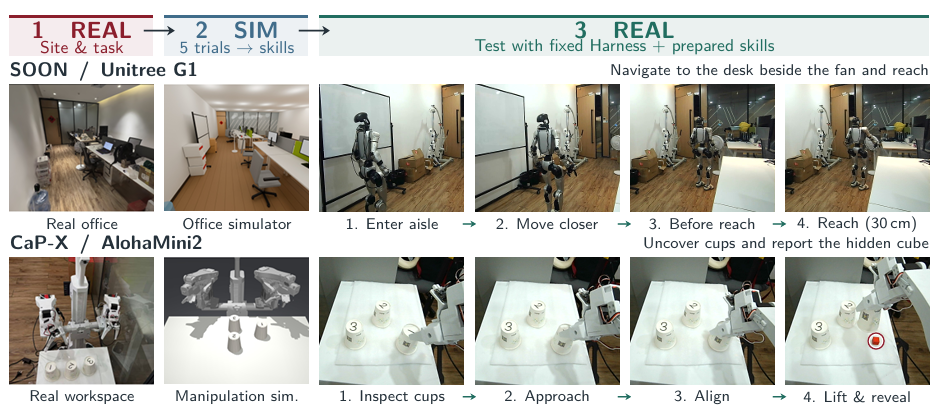
图7 Unitree G1与AlohaMini2的真实场景、模拟环境及任务执行过程(论文Figure 8)
04
什么驱动进化,
进化又塑造什么?
回到最开始的问题。
如果 RSI 始终由独立任务驱动,系统就容易围绕各自的局部目标改进。
增加任务数量,可以积累更多解决方案,却不一定让这些经验形成联系,沉淀为能够复用的能力。
扩大演化范围、改进版本选择和种子任务集、让决策 Agent 也参与演化,都在优化 RSI 的搜索与更新过程。
但即使改进器足够强、能够保留全部历史,仍需回答:哪些经验应该共享,哪些修改需要独立保留,又该依据什么组织不同任务的演化方向?
Capability-driven 将共同的能力需求作为改进依据。
The Trinity 以此组织环境、经验与 Harness 的演化,形成有结构的训练数据分布:
通过共享能力连接不同任务,通过不同分支保留各自的优化方向。
这样的组织方式,让局部改进有机会积累为可组合、可迁移的能力,也为缓解过拟合和 reward hacking 提供了可能。
RSI 的关键,可能不只是完成更多任务或持续运行 loop,而是选择什么驱动改进,以及这些改进最终能否沉淀为可共享、可组合、可迁移的能力结构。
END
关注+星标,获取AI前沿进展与开源一线动态
 关注公众号
 智猩猩AI的公众号