

 2026-10-22 19:17:40


智猩猩AI整理
论文作者投稿
给模型一组材料,让它作出选择,已经是许多 AI 应用里的常见操作。真正进入实际流程后,问题却不只是这一次选得对不对。
如果正确答案没有被放进来,它能否明确表示“都不适用”?
如果只是换了排列,它是否还会选择同一个对象?
如果候选越来越多,原有的决策方式能否继续使用?
如果材料早已处理过,新的请求是否还要支付重复计算的成本?
这四个问题,分别指向答案是否存在、顺序是否相关、候选规模如何变化,以及哪些计算可以复用。
它们会同时出现在文档选择、业务分流和自动评估中,也共同决定了一个决策模型是否好用。
新加坡国立大学 Qi Li 与 Xinchao Wang 的工作《Jeva: System One Models from First Principles》,将这四项要求作为架构设计的共同出发点。
Jeva 面向直接给出选择、概率和分数的 System One 决策,让 null-aware、permutation-invariant、option-scalable 与 cacheable 在同一模型中得到明确支持。
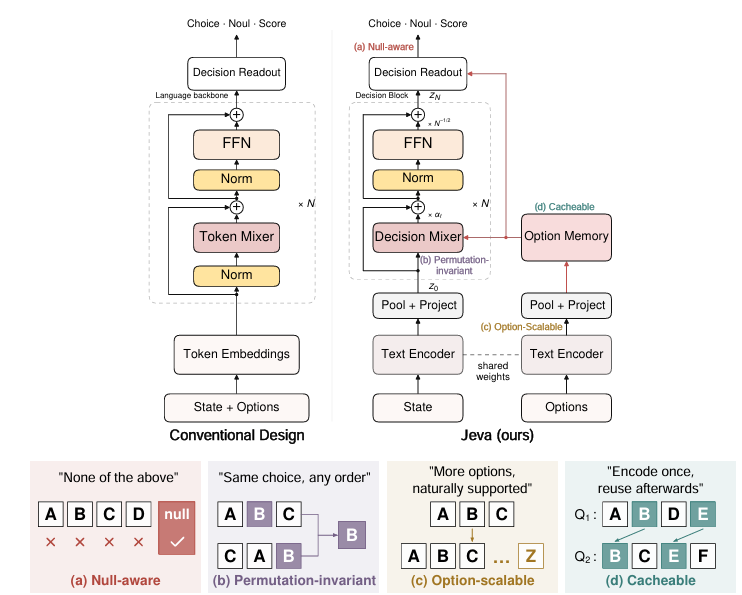
图 1|四项原则,共用一套决策架构。Jeva 分别表示请求和候选,让请求状态读取选项记忆后完成判断;覆盖估计、对称聚合、共享评分与选项缓存分别支撑下方四项结构特性
Jeva 先用共享语言编码器分别表示当前请求和每个选项,再让一个轻量决策模块读取完整的选项记忆,只更新请求状态。
最终判断由更新后的状态与候选共同产生。论文评测的 Jeva-4B 使用 Qwen3.5-4B 骨干和一个决策块。
在这套分工中,覆盖估计负责判断答案是否存在,对称聚合避免把排列当成判断依据,共享评分规则适配不同候选数量,独立的选项表示则支持跨请求复用。
四项能力各有对应机制,又共享同一条决策流程。
01
Null-aware:
没有合适答案,就明确说“没有”
用户需要办理账户注销,当前系统却只提供转账、查余额和修改密码。
三者总能排出一个“最相近”的选项,但第一名不等于合适的答案。
决策模型需要分清:是在几个可用答案之间拿不准,还是整个候选集都不适用。
Jeva 将两种判断分开。
候选竞争回答各选项之间如何比较,覆盖估计回答这里是否存在可接受的答案。
完整输出同时包含候选和 null,让答案缺席成为可以直接表达的结果。
图 2 给出了一个直观例子:
两个候选的分数一起降低,相对概率仍是 73% 和 27%,覆盖概率却从约 88% 降至约 12%。相对名次没有改变,集合整体的适用程度却不同。
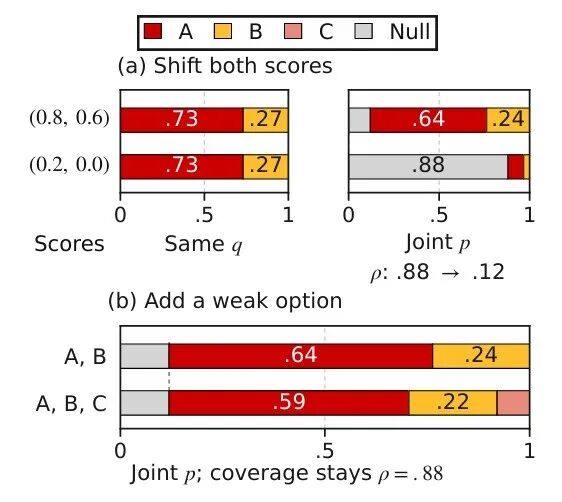
图 2|“谁更好”与“有没有”是两个问题。(a) 同幅降低分数,相对偏好 q 不变,覆盖概率 ρ 下降。(b) 在已有分数固定时加入低于最高分的候选,ρ 不变,候选概率重新分配
在 BANKING77 的 3,080 个请求中,每次提供 16 个候选,包含 588 个答案缺席的请求。
Jeva 的 null 检测 AUROC 达到 98.66%,高于 KEV-BF16 的 93.61%、InternDecision-4B 的 84.27% 和 JevK5 的 79.44%。
从实际工作点看,在约 5% 的有答案请求被误判为无答案时,Jeva 能识别约 94% 的答案缺席请求。
这项能力让系统不仅能够选择流程,也能判断现有流程是否覆盖当前需求。
02
Permutation-invariant:
位置变了,判断依据不变
Jeva 通过对称聚合读取选项,再使用共享规则评分。
从数学上看,重排候选只会相应重排输出概率;按候选身份对齐后,概率分配保持一致。
这样,排列不再被当成额外的判断依据。
顺序不应改变判断,候选内容却应当能够影响判断。
Jeva 的请求状态会读取整个集合,因此,即使保留 A 和 B,只改变第三个候选,也可以调整 A、B 的相对偏好。
论文用单个决策块给出了构造性证明;只依赖请求和单个候选的独立评分无法表达这种反转。
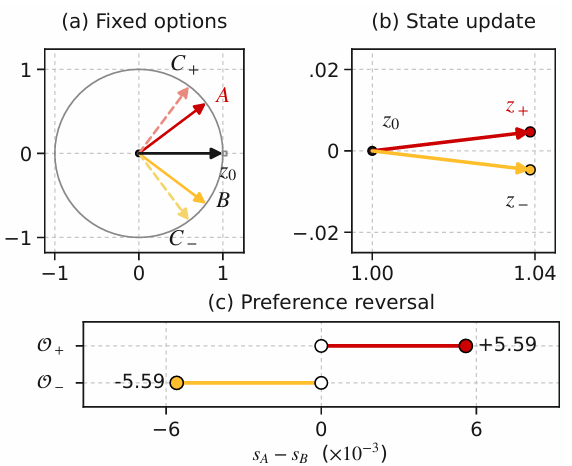
图 3|忽略位置,不等于忽略候选关系。固定初始请求状态和 A、B,将第三个候选由 C₊ 换为 C₋,单个决策块即可让 A、B 的相对偏好反转。改变的是集合内容,而非同一集合的排列
在 600 个 Choice 样本上,研究团队测试了原始排列、倒序和最多三种随机排列。
Jeva 没有出现决策翻转,原始准确率与所有测试顺序下均正确的准确率同为 76.67%。
作为对照,Jev、InternDecision-4B 和 JevK5 的翻转率分别为 17.00%、22.67% 和 26.17%。这项实验检验了同一判断能否经得起无关的排列变化。
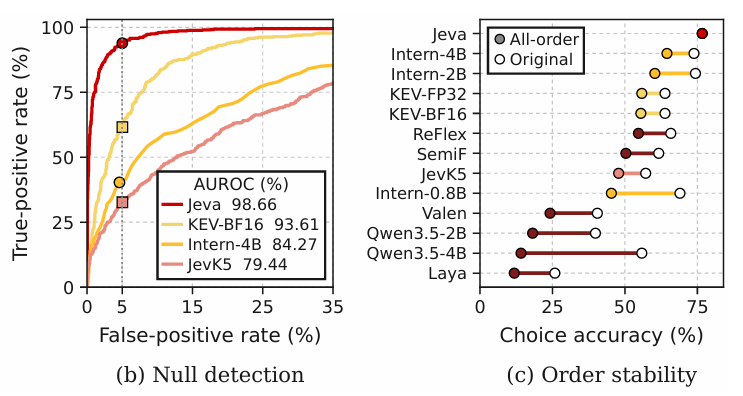
图 4|答案缺席与顺序稳定性的实验验证。左侧比较 null 检测的 ROC 曲线;右侧比较原始顺序准确率与所有测试顺序下均正确的准确率,分别对应前两项能力
03
Option-scalable:
候选增加,沿用同一套评分规则
业务目录会扩充,文档集合会增长。
若决策接口只提供固定数量的答案符号,候选扩容就需要额外处理;递归选择则通过多轮小规模比较,逐步筛出最终结果。
Jeva 对每个候选使用同一套评分规则,候选增加不要求扩展输出参数。文本可以分批编码,准备完成后,完整候选集共同进入决策模块。
这使编码批次与最终参与判断的集合大小得以分开。在固定决策宽度与深度下,准备好选项记忆后的决策计算随候选数量线性增长。
在 ToolRet 构建的六组规模实验中,Jeva 支持全部 500 个请求。
在单张 H200 的 2,048 候选设置下,它以 12.04 秒中位延迟达到 69.88% 准确率。
递归 JevK5 为 28.35 秒和 67.47%,对应准确率提高 2.41 个百分点、延迟加速约 2.35 倍。
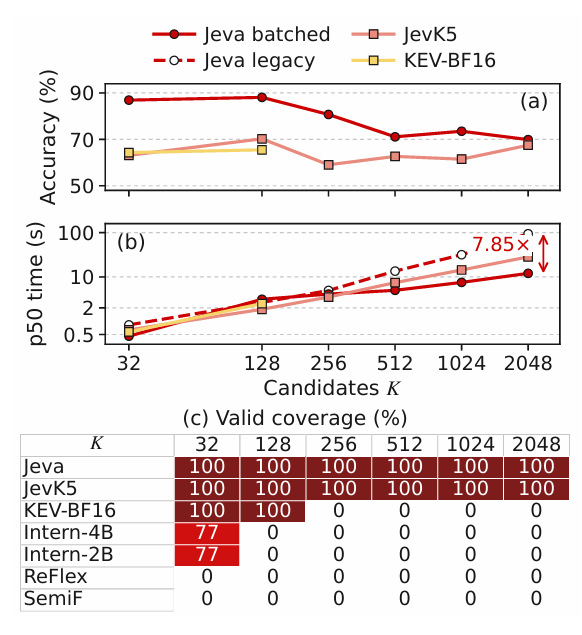
图 5|候选扩容后的准确率、延迟与支持范围。六组规模使用不同问题;准确率比较完整支持的设置。虚线对应 Jeva 的旧分批设置,7.85× 为同一模型的分批优化收益
进一步固定同一批 83 个问题,逐步将候选从 32 个增加到 2,048 个,Jeva 在所有测试规模下均答对的题目共有 58 道,JevK5 为 48 道,CLM 为 7 道。
除了能够接收更多候选,这项实验还检验了模型在扩容过程中保留正确判断的能力。
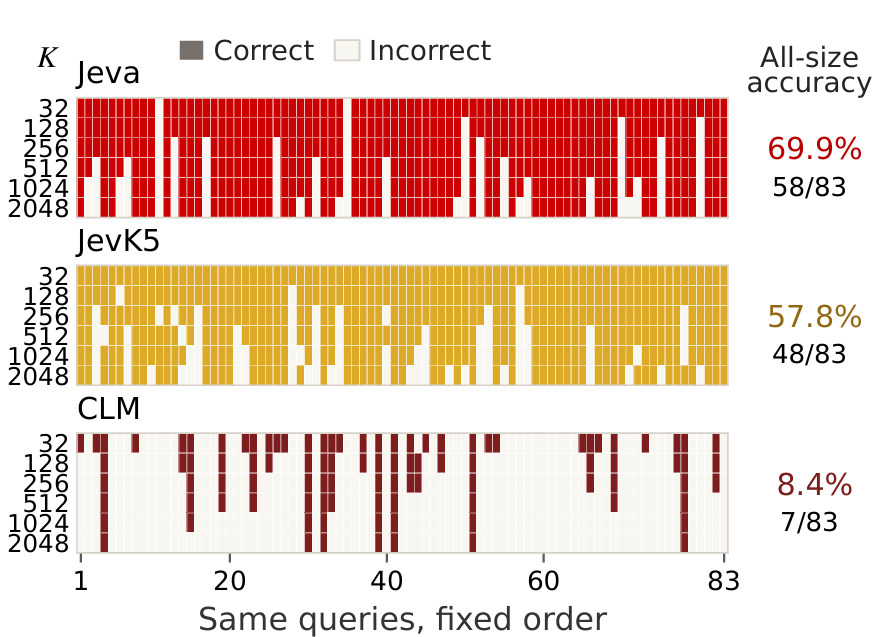
图 6|同一道题,候选逐步增加。每列对应一个固定问题,每行对应一种候选规模;彩色格表示预测正确。全部行都正确的列计入全规模正确数
04
Cacheable:
问题重新判断,已有计算继续使用
一份长文档可以被不同问题反复查询,一套政策条款可以处理多种业务,一组评分标准可以用于不同待评内容。
变化的是当前请求,候选材料却往往没有变化。每次重新处理全部材料,会把已有的信息再次变成计算成本。
Jeva 的选项表示不依赖当前请求,因此可以缓存语义向量,以及决策模块读取它们时使用的投影。
新的请求仍会被编码、更新状态并重新计算输出;复用的是候选侧计算,而不是上一次的答案。
这种复用也不要求整份名单原样出现。
此前处理过 A、B、C,下一次换成 B、C、D 时,B 和 C 可以直接取用,只需准备新的 D。
单个候选可以成为组合新集合时的可复用条目。
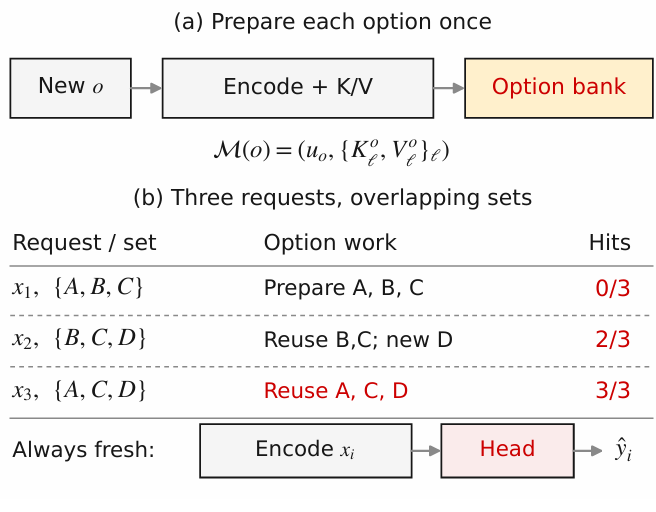
图 7|候选组合改变,已有条目仍可复用。图中依次展示首次准备、部分复用,以及新组合中的全部复用;每次请求的状态和决策都会重新计算
在单张 H200 的 MLDR 长文档实验中,当新组合的候选全部已缓存时,请求中位延迟由约 2.10 秒降至 75.1 毫秒,对应 27.98 倍加速,缓存预热单独计时。
配对的缓存条件下未观察到决策变化。
在模型参数、决策类型与编码设置一致时,同一批材料便可以服务不同问题,并按需重组为新的候选集合。
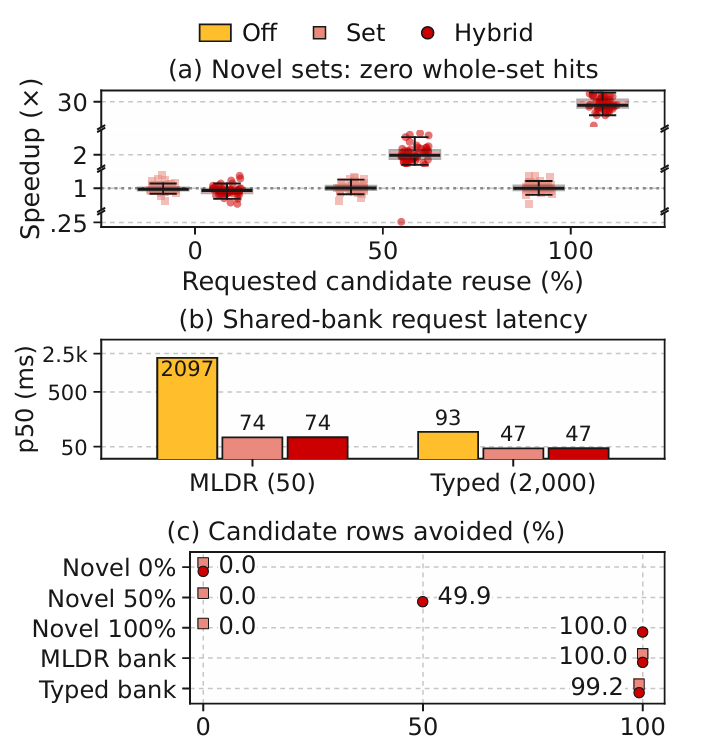
图 8|候选复用带来的延迟与计算节省。上方为新组合请求的配对加速比分布,中间为共享候选库的中位延迟,下方为避免编码的候选比例。27.98× 指完全复用时请求中位延迟的比值,预热另计
05
四项能力,回到同一个决策接口
在使用层面,Jeva 提供 Choice、Noul 和 Score 三种输出。
例如,同一份服务故障报告,可以用于选择处理团队、估计是否发生中断,以及评定影响程度。
Choice 返回选择与候选概率,Noul 返回命题为真的概率,Score 返回数值评分等级的期望值。其中,Noul 判断命题真假,null 则表示候选中没有合适答案。
从这个角度看,Jeva 提出的设计视角是:
直接决策不仅关乎答案怎样输出,也关乎模型怎样处理缺席的答案、无关的顺序、变化的候选数量与重复出现的信息。
四项要求共同进入架构,在同一套计算中得到回应。
该识别的缺席,明确识别;该忽略的顺序,不作依据;该扩展的候选,自然容纳;该复用的计算,无需重做。
END
关注+星标,获取AI前沿进展与开源一线动态
 关注公众号
 智猩猩AI的公众号