

 2026-10-28 19:00:00


智猩猩AI整理
编辑:林夕
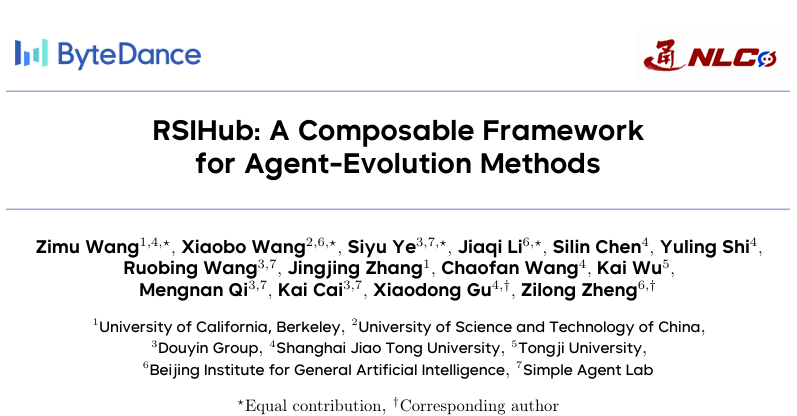
近日,字节跳动、上海交通大学、加州大学伯克利分校等机构联合提出开源框架RSIHub,将AHE、Hyperagents、A-Evolve和GEPA等进化方法,接入同一套执行与评测流程。
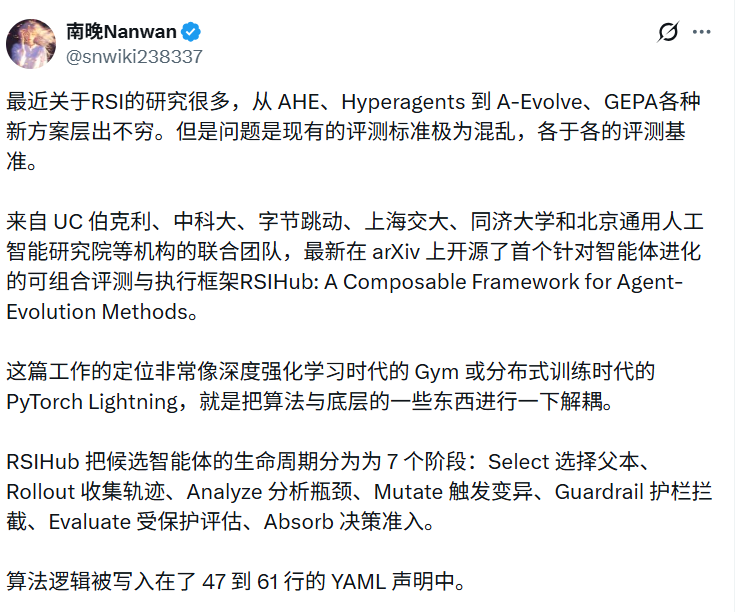
X用户在介绍这项工作时,将其定位类比为深度强化学习时代的Gym、分布式训练中的PyTorch Lightning:
把算法与底层设施分开,让研究者集中研究进化策略。
这个类比点出了RSIHub要解决的问题。
Agent已经能自己改Prompt、补技能、调整运行代码,但不同进化方法往往各搭一套系统,方法越来越多,究竟谁更有效,却很难放在一起比较。
RSIHub把这些尝试搬到共同的实验条件下。
MiniSWE在Terminal Bench 2上的pass@1最高提高13.5个百分点,但换一个Agent、换一类任务,领先的方法就可能变化。部分版本总分涨了,没参与修改反馈的保留任务反而退步。
让Agent自己改,已经有了多种方案;怎么判断它改得更好,正在成为新的研究重点。
01 一份Recipe,组合不同进化方法
Agent执行失败后,开发者会检查轨迹,修改提示词、工具、记忆或重试逻辑。
Agent进化方法尝试把这套调试工作自动化:根据执行反馈提出修改,再测试新版本。
但如何选择旧版本、分析失败和保留改动,不同方法各有设计。
但不同方法的重点并不相同。
有的优化提示词,有的积累技能,有的直接修改Agent代码;它们如何选择旧版本、如何分析失败、如何保留新版本,也各有设计。
RSIHub把这些方法中重复出现的流程拆开,整理成七个阶段:
选择父代、执行任务、分析轨迹、提出修改、检查边界、评测,以及吸收结果。
具体怎么完成每一步,由不同的算子负责。Recipe则选择这些算子,并配置它们的工作方式。
例如,同样是挑选父代,可以沿着当前最高分版本继续修改,也可以根据多个目标保留不同候选;同样是分析失败,可以使用完整轨迹,也可以先整理成更紧凑的修改依据。
这些差异,都可以成为单独测试的对象。
项目提供了A-Evolve、AHE、GEPA和Hyperagents等配方,分别覆盖提示词与技能优化、Harness修改,以及目标Agent和部分进化策略的共同演化。
对研究者来说,测试一个新想法,不必再从候选版本管理、任务执行和结果归档开始重做。
替换某个环节之后,可以继续沿用其余实验流程。
02 改不动了,“怎么改”也可以调整
自动修改Agent,仍然离不开一套预先设计的改进方法。
选哪个版本继续尝试,给修改者看哪些反馈,失败后是否保留经验,什么时候放弃一条路线,这些选择会影响最后能找到什么结果。
RSIHub为这部分策略的调整提供了接口。
一种方式,是把选定的进化算子放进允许修改的范围。
这样,候选版本变化的同时,负责分析或提出修改的部分代码也可以变化。
Hyperagents配方支持的,就是这类共同演化。
另一种方式发生在两轮迭代之间:由外层Agent根据允许使用的反馈,调整下一轮Recipe中的算子绑定和策略设置。
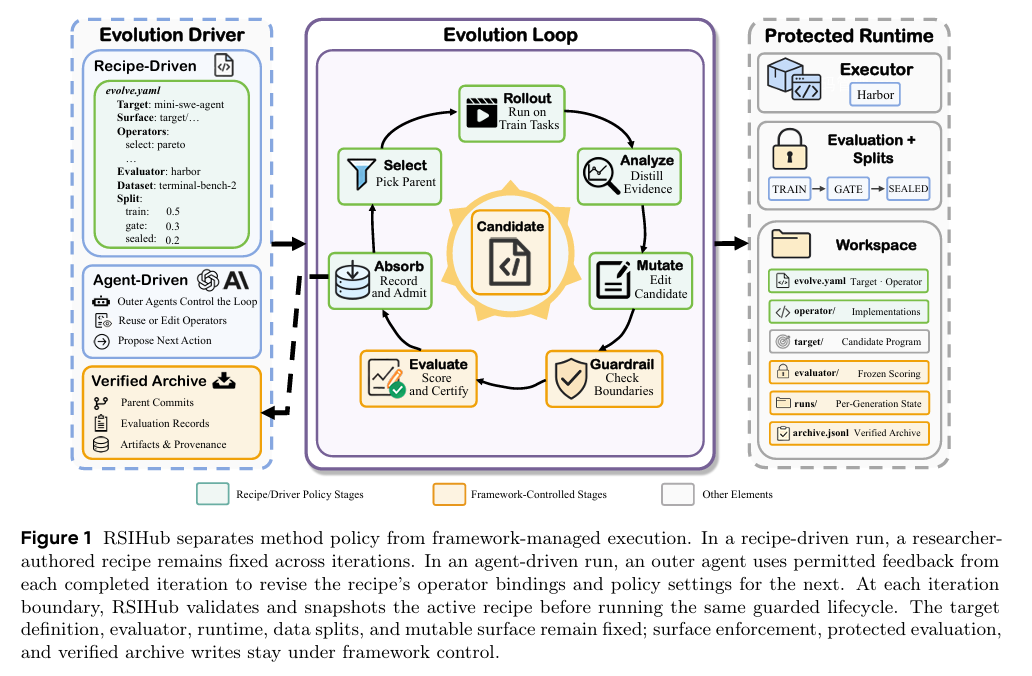
前一种修改组件实现,后一种调整组件的选择与配置。
于是,一次失败可以有两种处理方向:继续修正执行任务的Agent,或者重新检查产生修改的策略。
这也让递归自我改进有了更具体的研究入口。系统可以尝试改进任务执行方式,也可以研究怎样提高后续改进的效率。
但这些修改都有边界。
Recipe需要声明哪些资源允许变化。评测器和认证结果记录由框架控制,候选版本不能通过修改评分规则来获得更高成绩。
框架还会检查实际文件差异,再从干净的候选快照开展评测。
可以尝试更多修改,但每次涨分究竟对应什么版本、什么测试条件,仍然要能查清楚。
03 最高提升13.5个百分点,换个任务结果就变了
研究团队选择MiniSWE和Codex作为初始Agent,在Terminal Bench 2与τ³ Banking上比较四种进化配方。
目标模型统一使用GPT-5.4 high,负责提出修改的Agent使用GPT-5.4 xhigh,每次进化最多运行10代。
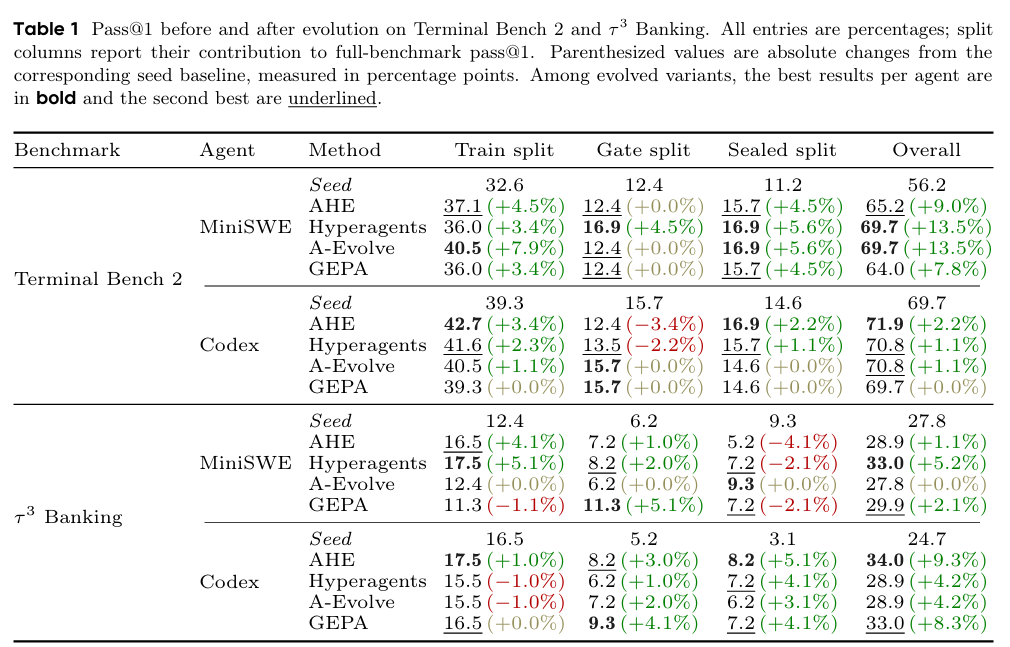
最明显的增益出现在Terminal Bench 2的MiniSWE设置中。
Hyperagents和A-Evolve都将整体pass@1从56.2%提高至69.7%,增加13.5个百分点。
换成初始成绩更高的Codex,提升则明显缩小:AHE取得最高结果71.9%,比初始版本增加2.2个百分点。
到了τ³ Banking,AHE将Codex从24.7%提高至34.0%;MiniSWE则由Hyperagents取得最高整体成绩,从27.8%提高至33.0%。
换一个起点、换一类任务,领先的方法就可能变化。
再看封存保留任务,结果还会复杂一些。这部分任务不参与修改反馈,用于检查改进能否转移到未见任务。
在τ³ Banking的MiniSWE实验中,Hyperagents虽然提高了整体成绩,封存保留任务上的表现却下降了。
AHE和GEPA在这一设置中,也出现了保留任务退步。
总分上涨,可能伴随着部分能力损失。参与优化的任务做得更好,也不能直接说明新任务上的表现同样改善。
因此,实验需要同时看两件事:修改有没有带来收益,这些收益能不能迁移。
RSIHub保留的候选历史、执行轨迹与结果记录,正是为了让研究者继续排查:
哪些改动修复了问题,哪些改动引入了退步,下一轮是否应该换一种策略。
04 Agent自己改,还得证明改对了
从优化Prompt、积累Skill,到修改Harness,Agent正在接手越来越多原本由开发者完成的调试工作。
RSIHub进一步将这些尝试接入共同流程,也为调整部分进化策略提供了接口。
论文实验表明,自动修改能够在部分设置下带来明显提升,但效果取决于初始Agent、任务和具体方法。
总分上涨的同时,保留任务也可能退步,持续进化还不能等同于持续变强。
RSIHub提供了一套继续研究这些问题的基础:替换策略、比较结果,沿着版本记录检查改动。
当Agent开始参与开发下一代Agent,哪些经验值得保留、哪些修改能够迁移,将直接影响这个循环能走多远。
 关注公众号
 智猩猩AI的公众号