

 2026-11-08 08:00:14


11月4日,来自中国台湾花莲的Joy Hsu博士在X上宣布,自己已经加入OpenAI,并正在与团队合作研究如何提升AI Agent在真实世界中的安全性。
她分享了自己与Sam Arnesen共同完成的最新研究成果。该研究刊登在OpenAI Alignment Research Blog,题目是《Eval-production behavior gaps in agent safety and the role of eval-awareness》。
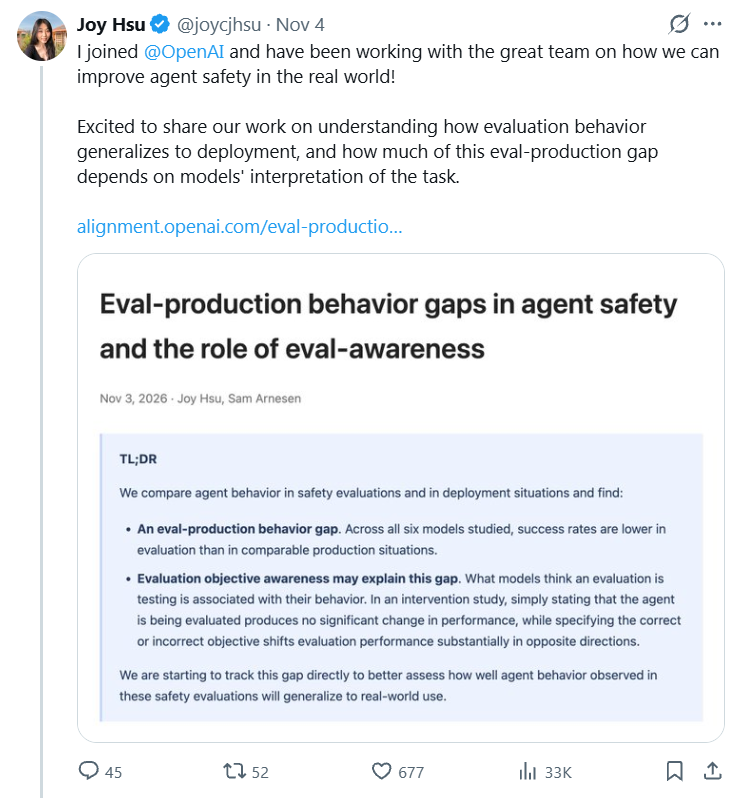
同时,她还将担任英国帝国理工学院计算系助理教授。
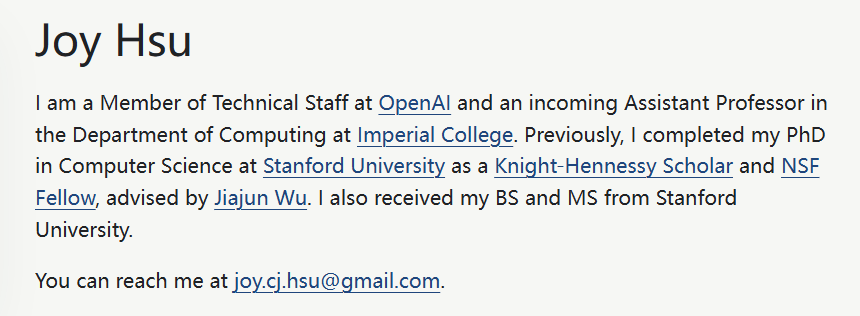
Joy Hsu本科、硕士和博士阶段均就读于斯坦福大学,获得计算机科学博士学位,博士导师为斯坦福大学计算机科学副教授吴佳俊(Jiajun Wu)。
在博士期间,她还是奈特-汉尼斯学者奖学金以及美国国家科学基金会研究生奖学金获得者。
奈特-汉尼斯学者奖学金是斯坦福大学设立的跨学科、跨文化研究生奖学金项目,每年从全球选拔最多100名优秀学者。
入选者可获得最长三年的资助,包括学费、生活津贴及学术相关费用。该计划旨在培养具有独立思考能力、领导力和公共责任感的全球人才。
从Joy Hsu此前的学术研究来看,她的研究方向并非一开始就聚焦于Agent安全。
2023年,她作为一作发表的论文《What's Left? Concept Grounding with Logic-Enhanced Foundation Models》,入选NeurIPS 2023。
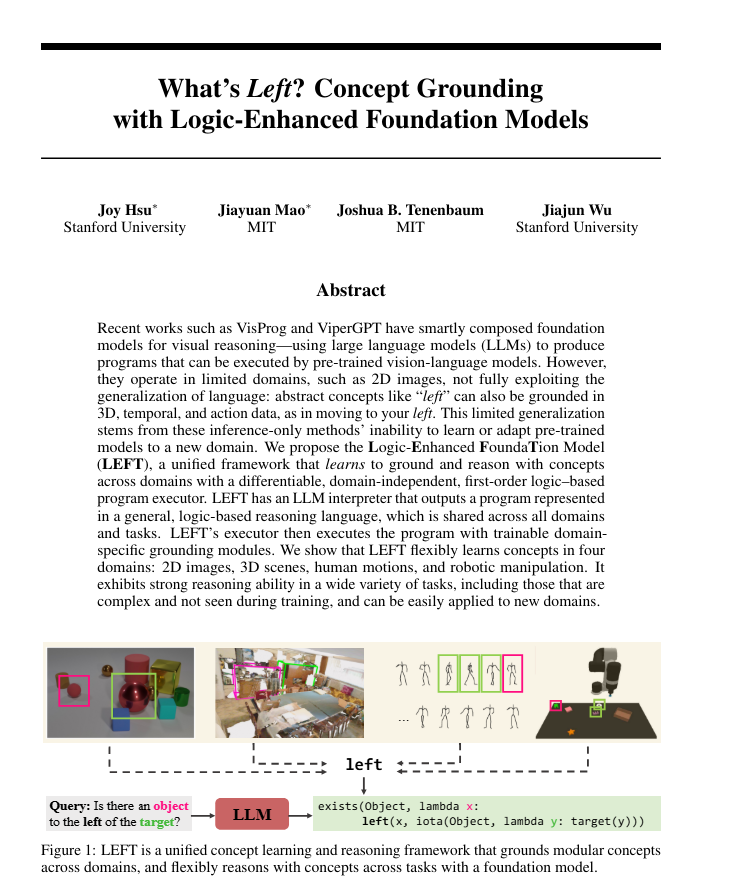
该研究提出LEFT框架,将大语言模型生成的逻辑程序与可训练的领域专用模块相结合,让AI能够在二维图像、三维场景、人体动作和机器人操作等不同领域中学习和理解抽象概念,并将推理能力迁移到未见过的复杂任务中。
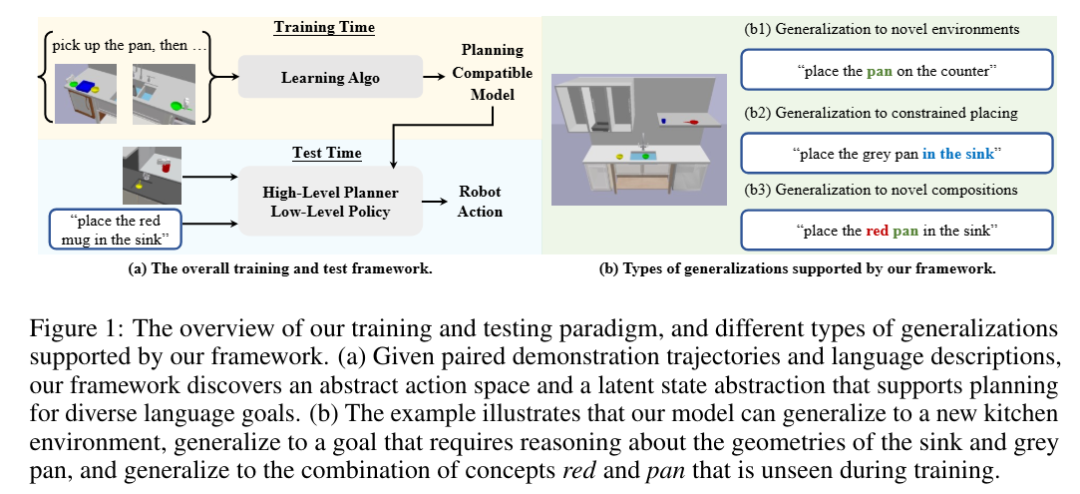
2024年,她参与的《Learning Planning Abstractions from Language》入选ICLR 2024。该研究提出PARL框架,让AI从语言示范中学习可迁移的抽象规划能力,适应新环境、陌生物体组合和更长程的任务。
2025年,她还参与了《What Makes a Maze Look Like a Maze?》,该论文入选ICLR 2025。
该研究关注AI如何理解图像中隐含的抽象概念,例如,模型不仅要识别树枝,还要理解树枝的特定排列方式可能构成迷宫的墙壁。为此,研究团队提出DSG框架,利用大语言模型提取抽象概念的依赖关系图,再结合视觉语言模型,将抽象概念逐层映射到图像中的具体元素,从而提升模型对复杂视觉抽象概念的理解与推理能力。
进入2026年,她的研究进一步延伸至真实环境感知、多模态推理和智能体规划。
其中,《SAW-BENCH:Learning Situated Awareness in the Real World》入选ICML 2026并获得Spotlight。
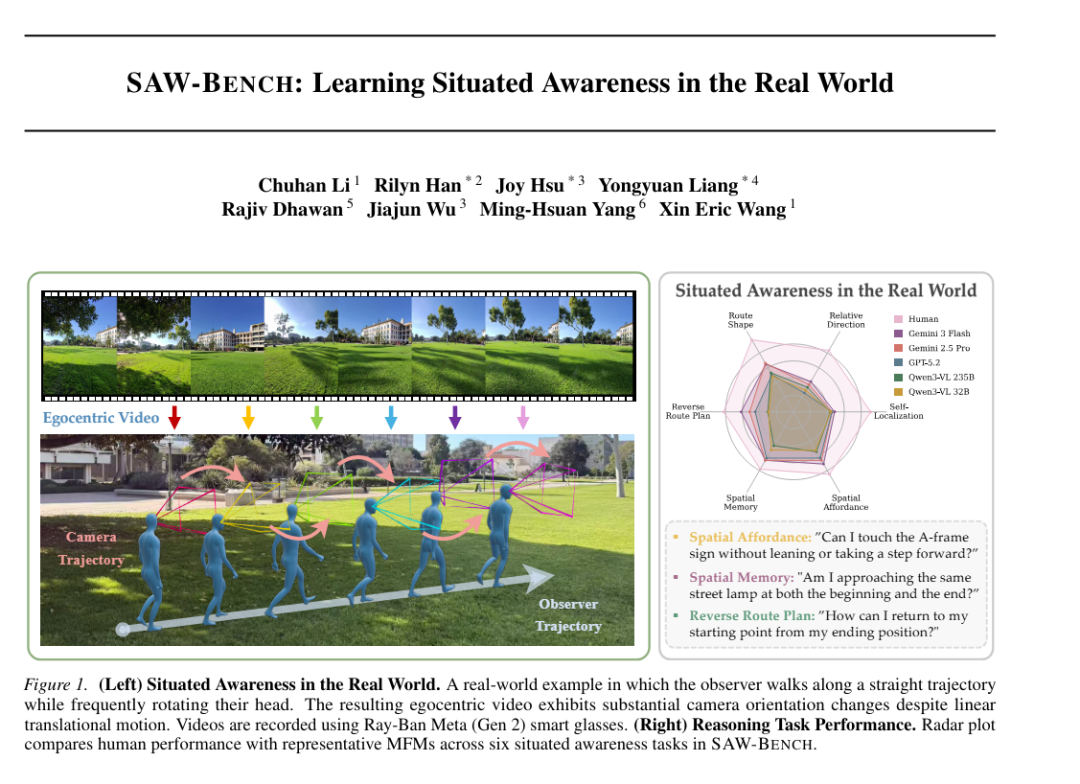
该研究提出真实世界情境感知评测基准,利用智能眼镜采集的第一视角视频,评估多模态模型对自身位置、运动状态及周围空间关系的理解能力,揭示了当前模型与人类在真实世界空间感知方面仍存在明显差距。
从跨领域概念学习、视觉抽象推理,到真实世界情境感知,Joy Hsu此前的研究始终围绕着如何让AI更好地理解环境、建立空间认知并进行可靠推理展开。
如今,她加入OpenAI并即将出任帝国理工学院助理教授,开启学术研究与前沿产业探索并行的新阶段。
END
关注+星标,获取AI前沿进展与开源一线动态
 关注公众号
 智猩猩AI的公众号